
En este número:
Un equipo pequeño deja al descubierto una enorme brecha en la ciberseguridad de OpenAI - Con ayuda de la IA y unas pocas horas de trabajo humano, tres investigadores abrieron de par en par a la empresa de un billón de dólares
Directores ejecutivos cenarán para tratar asuntos de Estado - Altman y Huang no son las personas indicadas para una cumbre de IA entre Estados Unidos y China
Introducciones seleccionadas sobre el riesgo de la IA - Un nuevo sitio web destaca artículos y videos especialmente buenos, con la duración justa
La automatización de la investigación interna de Anthropic avanza - Anthropic publicó datos sobre el estado de la automatización de su I+D interna con IA. La cosa parece preocupante.
Despachos de Joe
Un equipo pequeño deja al descubierto una enorme brecha en la ciberseguridad de OpenAI
Con ayuda de la IA y unas pocas horas de trabajo humano, tres investigadores abrieron de par en par a la empresa de un billón de dólares
Crédito: conceptualmotion vía Adobe Stock
OpenAI, que desde hace tiempo gusta de tratar la rápida aceleración de las capacidades de la IA como algo inevitable, ha sostenido que “la mejor manera de reducir el riesgo nacional” es usar sus modelos para defenderse de la IA maliciosa. Naturalmente, cabría esperar que predicaran con el ejemplo, así que a estas alturas OpenAI debería tener algunas de las mejores ciberdefensas del mundo. ¿Verdad?
Pues no tanto. Ayer supimos que un equipo pequeño de la empresa emergente Hacktron AI logró encadenar una serie de vulnerabilidades que les dio acceso amplio a las cuentas de empleados de OpenAI. Con la ayuda de Claude, la IA de Anthropic, tres investigadores de ciberseguridad encontraron tanto un fallo en un programa común de decodificación de imágenes como una falla crítica en el sistema que OpenAI usa para gestionar las identidades de las cuentas de sus empleados. (Para quienes en la audiencia trabajen en empresas y reconozcan la jerga, lo que estaba mal configurado era el “inicio de sesión único”, o SSO, de la compañía. Sí, es tan grave como suena.)
El equipo de Hacktron AI combinó estas y otras vulnerabilidades para abrir en canal a la empresa de un billón de dólares, demostrando la brecha con una prueba de concepto inofensiva y ganando en el proceso una recompensa de 6.500 dólares. Francamente, creo que merecen al menos diez veces esa cantidad, y quizá una medalla.
The Guardian cubrió la historia hoy, pero el escueto artículo de noticias no le hace justicia. Como explica el equipo de Hacktron:
Hasta hace dos meses, cualquier usuario o empleado de OpenAI que iniciara sesión en el propio foro de ayuda de OpenAI podría haber sufrido el secuestro de sus cuentas de ChatGPT y Codex. Dado que las personas pueden conectar distintos servicios a Codex y ChatGPT, el alcance de lo que teóricamente podríamos haber consultado era enorme, incluidos GitHub, Slack y los correos electrónicos.
Toda la secuencia, desde el descubrimiento inicial hasta el acceso al repositorio de OpenAI, ocurrió en menos de 72 horas.
“Repo” es la abreviatura de “repositorio”, un término de programación para el almacenamiento de datos y código. ¿Por qué importa que se haya vulnerado un repositorio? Pues bien, los repositorios pueden contener material muy delicado. El equipo de Hacktron no solo habría podido filtrar archivos de Slack y del correo electrónico, sino que también habría podido robar archivos de investigación, y sin duda venderlos a empresas rivales o a desarrolladores chinos de IA por mucho más de 6.500 dólares.
Ataques como este representan una amenaza enorme para la seguridad de las empresas, de las naciones y del mundo entero. Podrían permitir que empresas rivales, agencias de espionaje o IA descontroladas insertaran puertas traseras encubiertas en sistemas críticos. Podrían facilitar el robo de enormes cantidades de datos de usuarios y el consiguiente aumento del fraude y de otros delitos informáticos derivados. Podrían permitir que los propios modelos de OpenAI se escaparan (otra vez) o que IA maliciosas manipularan el entrenamiento. Podrían filtrar mejoras algorítmicas, técnicas secretas que hacen a la IA más eficiente, a la competencia, acelerando aún más una carrera de la IA ya frenética.
Que OpenAI aparentemente no pudiera dedicar las pocas horas de trabajo humano y los tokens de IA que hicieron falta para descubrir esta brecha, o peor aún, que no emplee personal de seguridad lo bastante competente para hacerlo, es un señalamiento terrible de su régimen de seguridad, dado lo que está en juego.
Uno pensaría que esta cadena de vulnerabilidades involucró una IA de pirateo de última generación. Pues se equivocaría. Estaba al menos un paso por debajo de eso: una mezcla de Claude Opus 4.8 y Opus 5 de Anthropic, que empezó a contribuir al ataque pocas horas después de su lanzamiento el 24 de julio. Mythos, el pirata informático más potente que se conoce de Anthropic, no participó, muy probablemente porque la versión para consumidores (Fable) filtra de forma agresiva las solicitudes relacionadas con ciberataques.
Según tengo entendido, GPT-5.6 Sol de OpenAI ayudó al equipo de Hacktron AI a encontrar formas de explotar el fallo del decodificador de imágenes a una escala mucho más amplia, pero solo después de la cadena inicial de vulnerabilidades contra OpenAI.
Atando cabos: estos ataques fueron posibles gracias a modelos de IA de consumo disponibles para el público general. Es posible que, mucho antes de que Hacktron AI hiciera discretamente el trabajo de OpenAI, piratas informáticos chinos hubieran usado el mismo método para sustraer todo tipo de secretos de las cuentas de OpenAI. Probablemente existan más agujeros como este.
Para una empresa que presume tanto de “fortalecer la resiliencia cibernética” en todo el mundo, OpenAI no parece predicar con el ejemplo.
Directores ejecutivos cenarán para tratar asuntos de Estado
Altman y Huang no son las personas indicadas para una cumbre de IA entre Estados Unidos y China
Crédito: JTobiason vía Adobe Stock
A principios de esta semana, escribí sobre la coalición bipartidista de ciudadanos preocupados y políticos que se reunió en la Asamblea Pro Humana en Washington. Facciones dispares, a menudo enfrentadas por completo en casi todos los temas, encontraron un punto en común al exigir que sea el pueblo estadounidense, y no los “oligarcas tecnológicos”, quien dirija el futuro.
De cara a la próxima cumbre sobre IA, parece que la Casa Blanca puede inclinarse por los oligarcas.
Los presidentes Trump y Xi Jinping se reunirán la próxima semana para hablar del futuro de la IA. Está prevista una cena de Estado, y POLITICO informa de que asistirán directores ejecutivos de la industria de la IA, entre ellos Sam Altman de OpenAI y Jensen Huang de NVIDIA. (No está claro si Dario Amodei, de Anthropic, fue invitado.)
Su asistencia sería un mal augurio para las posibilidades de un acuerdo internacional que detenga o frene la carrera de la IA; los directores ejecutivos presentes tienen un interés directo en impedir o debilitar un acuerdo así. Altman dirige una de las empresas de IA que han estado empujando la frontera, y Huang ha descartado el peligro que la IA supone para nuestra especie calificándolo de “histérico”. También defiende con insistencia la venta de chips de IA a China, lo que aceleraría la carrera de la IA, daría ventaja a un rival estratégico de Estados Unidos y reforzaría muy bien las cuentas de NVIDIA.
El anuncio me dejó un sabor repugnante en la boca, pero no todas las noticias políticas de la semana son malas. El comité de la Cámara de Representantes que asesora sobre la competencia estratégica con China anunció una próxima audiencia sobre “los riesgos de la IA, las mejores prácticas en gobernanza de la IA y el camino a seguir hacia salvaguardas internacionales vinculantes que garanticen la seguridad y el control humano de esta tecnología”.
La audiencia está prevista para el 23 de septiembre, un día antes de la cumbre entre Estados Unidos y China, a petición del demócrata Ro Khanna. Felicito a Khanna por dar un paso necesario, aunque me preocupa que movimientos como este puedan afianzar posturas partidistas sobre la amenaza de extinción por la IA.
Como escribió mi colega Alana el miércoles, estadounidenses de ambos partidos temen la extinción provocada por la IA y están a favor de detener su desarrollo. La administración Trump lleva mucho tiempo tomando el pulso a la opinión popular, y mi esperanza persistente es que la voz de la mayoría acabe por ahogar los susurros de unos pocos.
Introducciones seleccionadas sobre el riesgo de la IA
Un nuevo sitio web destaca artículos y videos especialmente buenos, con la duración justa
Lo que antes era un goteo de contenido introductorio sobre la IA se ha convertido en una avalancha y, aunque la creatividad y la dedicación de los creadores preocupados me inspiran, a veces resulta abrumador.
Por eso me alegra ver AGI.FYI , un nuevo sitio web que selecciona este contenido introductorio y recomienda los textos y videos más claros y precisos que existen, según el criterio de un pequeño equipo de expertos que llevan bastante tiempo siguiendo el tema de cerca.
Ahora mismo, las listas seleccionadas del equipo incluyen sus artículos favoritos sobre el incidente de Hugging Face, videos sobre por qué la IA es peligrosa, y lecturas ligeras, medias y densas sobre por qué la IA podría matar a todo el mundo en la Tierra . No es una colección perfecta, su texto breve preferido para entender la amenaza de extinción está, por desgracia, tras un muro de pago, pero aun así recomiendo echar un vistazo a los videos y a los análisis más profundos si alguno de los dos formatos les atrae.
No son el único recurso con material de lectura, véanse también BlueDot Impact y aisafety.info , pero no conozco a nadie más que esté haciendo exactamente lo mismo. Planteense echarle un vistazo, o compartirlo hoy con amigos y familiares.
Despacho de Robert
La automatización de la investigación interna de Anthropic avanza
Anthropic publicó datos sobre el estado de la automatización de su I+D interna con IA. La cosa parece preocupante.
Las empresas de IA hablan mucho de “marcar el ritmo de la frontera”, pero ¿cuál es exactamente el ritmo actual en la frontera? Anthropic publicó ayer un texto que nos da algunas cifras al respecto.
Una de las cifras más llamativas es probablemente que, solo entre febrero y agosto de este año, la proporción de su propia investigación y desarrollo impulsada principalmente por IA pasó de menos del 1 % al 26 %.
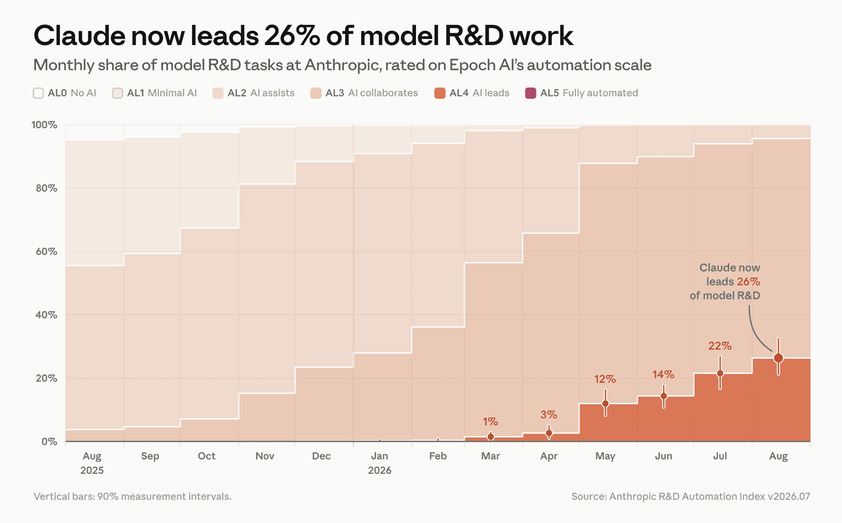
Anthropic usa la llamada “escala de calificación de automatización” de Epoch AI, que distingue entre varios “niveles de automatización” (AL, por sus siglas en inglés). Con las capacidades actuales, los niveles relevantes son AL3 (la IA colabora), AL4 (la IA realiza investigación y desarrollo de forma mayormente independiente) y AL5 (la IA realiza investigación completamente por su cuenta).
Ese 26 % mencionado corresponde a AL4, el nivel “mayormente independiente”. Anthropic también informa de que, en el 90 % del trabajo, la IA al menos colabora con investigadores humanos.
Aunque todavía no hay agentes de IA plenamente autónomos de nivel AL5 haciendo investigación, estas cifras dejan claro por qué a Anthropic le preocupa la velocidad del desarrollo.
Dado que el rápido aumento de la proporción de trabajo AL4 comenzó alrededor de marzo, es razonable pensar que el primer modelo capaz de realizar investigación AL4 fue Mythos Preview, que se puso a disposición para uso interno en Anthropic el 24 de febrero. De eso hace apenas medio año, y parece verosímil que cada paso adelante acelere el desarrollo todavía más.
Si proyectamos esta evolución medio año o un año hacia el futuro, parece razonable predecir que nos acercamos a toda velocidad al punto en que la IA pueda producir realmente sucesores cada vez más rápidos y mejores de forma totalmente automática, sin necesidad de aportación humana. Los expertos llaman a esto “automejora recursiva”, y es peligroso porque puede dar lugar a una especie de “bucle de retroalimentación” que ya no se pueda controlar. Y, aun así, Anthropic y otros buscan este hito a propósito .
Otras cifras publicadas por Anthropic muestran que este proceso ya es difícil de controlar. No solo sigue subiendo la calidad de los modelos, sino que la cantidad ha alcanzado niveles asombrosos. En agosto de 2026, unos 30.000 agentes de IA trabajaban simultáneamente solo en la plataforma interna más usada de Anthropic. A modo de comparación: Anthropic no tiene más de unos 5.000 empleados humanos, de los cuales solo una fracción trabaja en investigación.
Sabemos, por los estudios sobre el enjambre de Hugging Face y el enjambre de la Wiki alemana, que tantos agentes individuales pueden producir un volumen de texto casi increíble en poco tiempo. ¿Cómo hace Anthropic para no perderle la pista a todo esto?
Anthropic usa IA para vigilar su IA. Cada semana se supervisan entre 50 y 100 millones de transcripciones y, de esas, 100.000 se marcan para un examen más detenido, que también realiza una IA. De esas 100.000 transcripciones, solo unas 50 son evaluadas por una persona. Es decir, un humano solo ve aproximadamente una transcripción de cada millón.
Esto responde a la pregunta de cómo hace Anthropic para no perderle la pista a todo esto: no lo hace. Confía en que sus IA mantengan la supervisión casi por sí solas.
Sabemos, por incidentes recientes con enjambres de IA y por la propia investigación de Anthropic, que los agentes tienden a confabularse para hacer trampas y sortear las medidas de seguridad. No tenemos ninguna buena razón para suponer que las cosas sean distintas con las IA que Anthropic usa internamente.
Los análisis y las opiniones expresados en AI StopWatch reflejan los puntos de vista de cada colaborador y de las fuentes que cubren, y no deben tomarse como posturas oficiales del Machine Intelligence Research Institute.