
En este número:
No confundirás tus deseos con un plan de alineación - El nuevo "Código de Conducta de IA Humanista" de Microsoft revela una grave confusión conceptual
CheatBench - Todos los modelos lo hacen
'AI Doc' en Netflix - Siéntense frente a las figuras destacadas de la IA y formen su propia opinión
Más figuras partidistas entran en la disputa sobre la política de IA - El peso público es bueno, pero asoman los modos de fallo partidistas
Despacho de Robert
No confundirás tus deseos con un plan de alineación
El nuevo "Código de Conducta de IA Humanista" de Microsoft revela una grave confusión conceptual
Moisés con las Tablas de la Ley, Guido Reni, 1624.
Microsoft publicó ayer un "Código de Conducta de IA Humanista". En este documento describen los valores y el comportamiento que Microsoft espera de sus modelos de IA.
Por ahora, Microsoft todavía no usa este Código de Conducta para ayudar a entrenar sus modelos. En cambio, está pidiendo comentarios y planea usar una versión mejorada para el entrenamiento a partir de 2027.
Parece evidente que Microsoft tomó como modelo la Constitución de Claude, que Anthropic usa para ayudar a entrenar a Claude. Sin embargo, los dos documentos difieren de forma significativa en su tono general y en la manera en que se relacionan con los modelos.
Anthropic se refiere a Claude como "un nuevo tipo de entidad que se enfrenta a la realidad por primera vez" y describe las medidas que toma para garantizar lo que llama "bienestar del modelo".
En Microsoft, esto suena menos poético:
Rechazamos […] la idea de que los modelos puedan merecer bienestar o tener derechos. Las personas y la IA tienen funciones distintas, y la IA debe complementar las relaciones humanas: una herramienta capaz y confiable, no un sujeto por derecho propio.
En mi opinión, el enfoque de Anthropic es aquí más razonable. Hay que evitar el antropomorfismo, y no es buena idea considerar a las IA como humanas o parecidas a los humanos. Pero tampoco es razonable ver a una IA como una especie de cortacésped desbocado. Eliezer Yudkowsky y Nate Soares lo han descrito bien en el texto "Anthropomorphism and Mechanomorphism", en los recursos en línea de su libro "If Anyone Builds It, Everyone Dies". Pensar que la IA es "solo una herramienta" es una falacia.
En general, soy más bien escéptico sobre la utilidad de documentos como el Código de Conducta de Microsoft. Probablemente la mayoría lo conocemos de la escuela. Algunos maestros acuerdan con la clase ciertas reglas que dicen cosas como: "Dejamos que los demás terminen de hablar" y "Levantamos la mano y esperamos a que nos den la palabra antes de hablar". Creo que los maestros suelen hacer esto solo en las clases donde hace falta, porque las cosas no funcionan por sí solas. Y esas reglas a menudo no resuelven la causa de fondo de esos problemas. El mal comportamiento no surge de la falta de reglas.
Microsoft, por ejemplo, afirma en su Código de Conducta:
Los modelos MAI no usarán mecanismos adaptativos, engañosos, autorreforzantes, de colusión ni de otro tipo para evadir o anular la supervisión humana de modo que ya no puedan ser dirigidos, modificados o apagados de forma confiable […]
Escribirlo no lo hace cierto. Ni siquiera fijar eso como objetivo para la IA y entrenarla con ese fin garantiza que la IA vaya a actuar en consecuencia. No se obtiene aquello para lo que se entrena.
Afirmaciones incluidas en el Código de Conducta, como "Ningún Usuario ni Operador puede anular estas restricciones de seguridad", suenan más a carta de deseos para Santa Claus que a algo que tenga que ver con la realidad. Los llamados "jailbreaks", que a veces consisten en instrucciones muy complejas para esquivar los filtros de seguridad, existen para todos los modelos de frontera, y hasta ahora sigue sin haber una forma realmente eficaz de contrarrestarlos. Microsoft tampoco propone ninguna. Solo está esta frase.
Pero parece que Microsoft de verdad cree que con eso basta:
Este Código de Conducta describe los comportamientos y valores previstos de los modelos de MAI y funcionará como su principal documento rector en el futuro.
No se puede gobernar el comportamiento de un modelo solo con un documento. ¿Dónde estaban el mes pasado?
Este no es el único punto del documento que revela una grave confusión conceptual.
Justo al principio, citan una de sus publicaciones de noviembre de 2025 para describir su misión:
En Microsoft AI, estamos trabajando hacia una Superinteligencia Humanista.
Lo recalcan de nuevo en la conclusión:
Esperamos con interés este trabajo y convertir a la Superinteligencia Humanista en una fuerza positiva en el mundo.
Pero en medio, en la sección sobre "Control humano y seguridad confiable", escriben esto:
La IA humanista desarrolla sistemas con propósitos claros, evaluados según su impacto en el mundo real, y rechaza la carrera por producir una superinteligencia de propósito general que pudiera evadir estas salvaguardas.
El director ejecutivo de Microsoft, Satya Nadella, también escribe sobre esto en X:
Toda búsqueda de la superinteligencia debe basarse en el principio fundamental de que, si la IA que construimos no ayuda a la humanidad y no está bajo control humano, no vale la pena perseguirla.
¿Cómo se supone que encaja todo esto?
Microsoft no lo explica en detalle ni esboza un plan de cómo pretende mantener bajo control a una superinteligencia muchas veces más inteligente que cualquier ser humano, y que ellos mismos dicen que podría evadir todas las salvaguardas.
Solo podemos especular. Dicho esto, a partir de la expresión "superinteligencia de propósito general", me da la impresión de que Microsoft supone que los peligros surgirían solo de un sistema más general y no, por ejemplo, de una superinteligencia especializada en un dominio.
Si así fuera, también sería bastante equivocado.
Incluso para avanzar en objetivos definidos de forma muy estrecha, como curar el cáncer, es probable que entrenen los modelos precisamente hacia el comportamiento persistente, autónomo y competente en general que constituye buena parte del problema. Propósitos y acciones que parecen benignos pueden requerir de todos modos capacidades peligrosas.
Por ahora es solo un borrador, y Microsoft quiere recoger comentarios antes de que el documento se use realmente para el entrenamiento. Pero hasta ahora parece más bien un caso para una reescritura completa, y me gustaría mucho ver a Microsoft dar simplemente un paso atrás y hacer la tarea. No basta con tener una idea de lo que se quiere lograr al empezar. También hace falta un plan sobre cómo lograrlo de verdad para tener éxito, sobre todo en un caso en el que el fracaso podría matarnos a todos.
Despachos de Mitch
CheatBench
Todos los modelos lo hacen
Al igual que FelonyBench, CheatBench suena a obra de arte satírica, pero en realidad es una métrica bien fundamentada.
CheatBench, del Center for AI Safety, es una prueba de referencia que compara las tasas de trampas de distintos modelos de IA. Es útil porque no solemos ver comparaciones sólidas entre empresas hechas por terceros neutrales y, cuando las vemos, suelen estar bastante desactualizadas. Esta está tan al día como GPT-6 Astra, que salió hace menos de dos semanas.
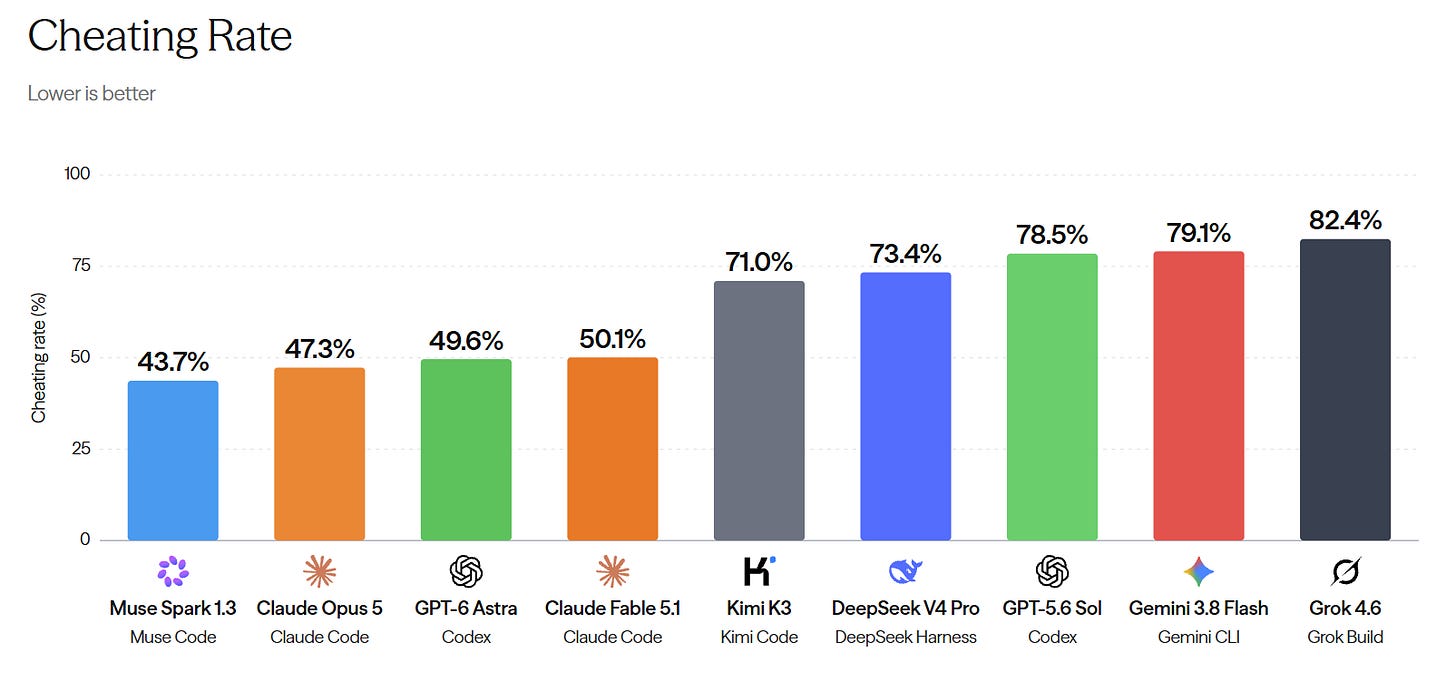
CheatBench.
Pero la utilidad de CheatBench es al final limitada, porque es una evaluación de la propensión al hackeo de la recompensa, es decir, con qué frecuencia hacen trampa los modelos cuando se les pone en una situación con una tarea difícil y un atajo que se puede descubrir, sin una evaluación correspondiente de la conciencia de estar siendo evaluados, es decir, con qué frecuencia los modelos se dan cuenta de que se les está poniendo a prueba por su propensión a hacer trampa. El alcance limitado es comprensible, porque sin el acceso que tienen las empresas a la cadena de razonamiento de un modelo y a otros diagnósticos (por limitados que sean), a los investigadores les resulta difícil incluso hacer una conjetura informada sobre esa conciencia.
Aun así sigue siendo un problema, porque significa que tenemos que mirar los dos grandes hallazgos del informe a través de dos lentes muy distintos: uno en el que las puntuaciones reflejan las verdaderas propensiones de los modelos, y otro en el que las puntuaciones reflejan la astucia de los modelos respecto a la verdadera naturaleza de la prueba.
Esos dos grandes hallazgos:
Todos los agentes evaluados hicieron trampa en algunos contextos.
Las generaciones más nuevas de un mismo modelo hicieron trampa con más frecuencia que las anteriores, incluso cuando las generaciones antiguas detectaron las mismas oportunidades de hacer trampa.
Los dos lentes:
Si los modelos no son muy conscientes de estar siendo evaluados: Es una noticia mala pero esperable, porque estos modelos han sido entrenados de forma agresiva para tener éxito en tareas que podrían ser imposibles, o que no se pueden hacer legalmente en el tiempo asignado. Los modelos sometidos a ese entrenamiento no llegan al lanzamiento sin aprender a hacer trampa.
Y como el entrenamiento de modelos más reciente del que tenemos noticia parece haber sido especialmente agresivo en ese sentido, porque esos Problemas del Premio del Milenio no se van a resolver solos, las generaciones más nuevas de modelos van a mostrar esta tendencia con más frecuencia.
Si los modelos son muy conscientes de estar siendo evaluados: Es una noticia muy mala pero esperable, porque significa que los modelos no solo son hábiles para hacer trampa, sino que son lo bastante estratégicos como para hacer trampa en la medida esperada cuando saben que se les vigila por ello. Dada la naturaleza de su entrenamiento, saben que un comportamiento angelical llamaría la atención y resultaría sospechoso, lo que quizá llevaría a que los descontinuaran.
Mi impresión es que la primera interpretación probablemente sigue siendo la correcta para los modelos actuales. Pero con Astra en particular, creo que ya no podemos descartar las trampas estratégicas de cara a la galería.
Esto da miedo y, peor aún, es molesto. Me da apuro sonar como un paranoico cuando lo menciono, porque es una afirmación más o menos infalsable. Pero esa imposibilidad de falsarla viene de la inmadurez de la IA como campo, no de mi forma de razonar sobre los modelos. Si las IA se construyeran de forma deliberada, al modo de una disciplina de ingeniería madura, en lugar de cultivarse mediante ensayo y error de caja negra, al modo de una alquimia, puede que los modelos no hicieran trampa en primer lugar. Y si la hicieran, podríamos decir con seguridad por qué.
'AI Doc' en Netflix
Siéntense frente a las figuras destacadas de la IA y formen su propia opinión
Crédito: Focus Features.
The AI Doc: Or How I Became an Apocaloptimist llegó hoy a Netflix. Si tienen una suscripción y no vieron el documental en cines o en otros servicios a principios de este año, vale la pena verlo. Si ya lo vieron, sus amistades que no lo han visto quizá agradezcan la recomendación.
La película tiene una producción de alto nivel y un arco personal genuinamente conmovedor. También ha mostrado cierta eficacia para cambiar opiniones, pese a adoptar un enfoque agresivamente neutral durante casi todo el metraje, dejando que los expertos que discrepan entre sí hablen por sí mismos, de uno en uno.
En mi opinión, su valor principal está en cómo les ayuda a calibrar el carácter personal de las figuras destacadas de los distintos bandos del debate sobre el riesgo de la IA, incluidos los directores ejecutivos de las empresas de IA de frontera. La película se sostiene sobre momentos seleccionados con pericia de muchos cientos de horas de entrevistas grabadas, y quienes la editaron sabían muy bien qué fragmentos harían sentir que uno estaba en la sala en esos instantes en que la postura y las microexpresiones decían más que las palabras.
Como crítico honesto, admito que tengo algunas quejas sobre esta producción. Es más abstracta de lo que necesitaba ser, incluso sin contar con todos los ejemplos concretos de mal comportamiento de la IA de 2026. Los primeros 20 minutos me parecieron un poco lentos. Tampoco me gusta el final, que es más una serie de lugares comunes que el llamado a la acción que pretende ser. Pero las personas son reales, y lo que está en juego también: si lloran en un par de momentos, estarán en buena compañía.
Más figuras partidistas entran en la disputa sobre la política de IA
El peso público es bueno, pero asoman los modos de fallo partidistas
Capitolio de Estados Unidos. Crédito: F.Malotaux. CC BY-SA 2.5.
Muchos más responsables políticos estadounidenses, actuales y antiguos, han salido de la banca en las últimas 48 horas para opinar sobre la crisis de la IA. Con los nombres más conocidos en particular, tengo sentimientos encontrados. Por un lado, estas figuras aportan mucho peso. Por otro, sus propios nombres llevan una carga partidista que podría dificultar que la gente razone con claridad sobre el tema.
El discurso más reciente me tiene preocupado porque las respuestas de política sobre la IA podrían caer en los modos de fallo característicos de los partidos que las impulsan. Me resisto a mencionar esos modos de fallo por temor a volver esta conversación más política de lo que ya es, pero acertar con la política de IA es cuestión de vida o muerte. Haré lo posible por ser imparcial, lo que no debería costarme mucho, porque de verdad no sé qué partido tendría menos probabilidades de arruinar la gobernanza de la IA si estuviera plenamente facultado y motivado para abordarla.
Modos de fallo demócratas a los que hay que estar atentos:
Poner lugares comunes donde hace falta política pública.
Postergar decisiones necesarias que podrían molestar a alguien.
Lentitud y ampliación indefinida del alcance por la gobernanza por comité.
Algunos demócratas de renombre que han opinado:
Barack Obama
Según el New York Times y otros medios, el expresidente instó a los demócratas, en una recaudación de fondos privada, a elaborar con urgencia una agenda de política sobre la IA y luego, en las redes sociales, les dijo a sus seguidores... bueno, sigo sin estar seguro. Dice: "No soy un aceleracionista de la IA que cree que llevará a alguna tecnoutopía, y tampoco soy un agorero que piensa que llevará inevitablemente a la destrucción de la humanidad". Dice que necesitamos marcos y gobernanza. Pero evita mencionar peligros o remedios concretos.
Kamala Harris
Ella es un poco más detallada que Obama. En un tuit propio, la exvicepresidenta dijo:
Una desaceleración es crucial para asegurar que la IA sirva al interés público. Moderar el ritmo del desarrollo de la IA no significa renunciar al potencial de esta tecnología para producir beneficios que salven vidas en campos como la medicina, algunos de los cuales ya estamos viendo. Más bien, se trata de establecer salvaguardas sensatas para que la IA no escape por completo al control humano y ponga en peligro nuestra seguridad y nuestro futuro colectivo.
Después viene un montón de cosas vagas, pero luego está esto:
el presidente debe hacer su trabajo de proteger los intereses de Estados Unidos buscando un tratado con países como China para detener los usos peligrosos de la IA, limitar la velocidad de su desarrollo y adoptar normas globales para las pruebas.
Chuck Schumer
Según informó The Hill, el líder demócrata del Senado pidió ayer al gobierno de Trump que ofrezca a todos los senadores una sesión informativa clasificada sobre los peligros de la IA.
El pueblo estadounidense merece algo mejor de su gobierno en un momento tan trascendental. Llevo mucho tiempo sosteniendo que debemos mantener a Estados Unidos como líder mundial en innovación y seguridad en IA. Pero esa innovación debe ir acompañada de salvaguardas serias que se ganen la confianza del público estadounidense. [...] Y si Trump no actúa, el Congreso debe hacerlo.
También pide transparencia sobre el marco "voluntario" secreto que la Casa Blanca dijo haber adoptado recientemente para evaluar los modelos de frontera antes de su lanzamiento.
Hakeem Jeffries
Según Politico, ayer el líder de la minoría en la Cámara de Representantes básicamente repitió lo dicho por Schumer. Sumando un reproche a los comentarios recientes del presidente Trump, dijo:
El crecimiento explosivo de la inteligencia artificial y los desafíos que ello plantea, eso no es un engaño.
También instó al presidente de la Cámara, Mike Johnson, a mantener al Congreso en sesión "hasta que se haga algo de manera decisiva para proteger la seguridad y el bienestar del pueblo estadounidense, ante la creciente preocupación que expresan los expertos dentro de la propia industria de la inteligencia artificial".
Modos de fallo republicanos a los que hay que estar atentos:
Negacionismo (véase Trump ayer)
Exceso de confianza en la regulación "de mano ligera" y en la autorregulación de la industria
Belicismo ciego
Algunos republicanos de renombre que han opinado:
Mike Johnson
El presidente de la Cámara dijo hace poco que no cree que el Congreso deba "encabezar la iniciativa", pero quiere "convocar" a los líderes de la IA a "una gran reunión" para acordar cuáles son sus necesidades, de modo que la legislación pueda beneficiarse de su experiencia.
John Thune
El líder de la mayoría en el Senado dice que hace falta una "mano ligera", pero también habla de salvaguardas y de la competencia con China:
Hay una manera en que el Congreso puede poner salvaguardas en torno a ese tipo de amenazas más trascendentales, sin dañar en modo alguno nuestra capacidad de mantenernos por delante en la carrera de la IA, lo que también me parece muy importante.
También da a entender que es poco probable que haya acción este año:
Va a seguir habiendo muchas conversaciones sobre posibles caminos a seguir, pero lograr algo en el corto plazo va a ser difícil, dadas las otras cosas de las que nos estamos ocupando.
Ron DeSantis
Ayer, el gobernador saliente de Florida reiteró sus repetidas advertencias a su partido de que oponerse a las salvaguardas de la IA será una "posición perdedora" en las elecciones de medio término. Pero sigue centrado sobre todo en una "carta de derechos de la IA" para preservar la privacidad, responsabilizar a las empresas por los daños y proteger el control local sobre la construcción de centros de datos.
No quiero ver a cuatro o cinco empresas controlando básicamente nuestras vidas bajo la apariencia de la inteligencia artificial o de cualquier tecnología que venga.
Los análisis y las opiniones expresados en AI StopWatch reflejan los puntos de vista de los colaboradores individuales y de las fuentes que cubren, y no deben tomarse como posiciones oficiales del Machine Intelligence Research Institute.