
En este número:
Una coalición improbable se reúne en Washington - Legisladores y ciudadanos dejan de lado sus diferencias para mantener el futuro en manos humanas
Primer aniversario de "If Anyone Builds It, Everyone Dies" - Miramos atrás para poder avanzar
Con los ojos bien abiertos - Una encuesta de Politico muestra que el 63 % de los estadounidenses cree que la IA podría destruir a la humanidad
Comportamiento emergente - Un nuevo estudio analiza cómo se comportan los agentes cuando se los deja interactuar con su entorno durante días o semanas
Despachos de Joe
Una coalición improbable se reúne en Washington
Legisladores y ciudadanos dejan de lado sus diferencias para mantener el futuro en manos humanas
Un puente en construcción. Crédito: hayoshka vía Adobe Stock
Aquí va un acertijo: ¿qué tienen en común el estratega político republicano Steve Bannon, la congresista demócrata Lori Trahan, el arzobispo católico Salvatore Cordileone, el físico del MIT Max Tegmark, la actriz y activista Ashley Judd, el conservador acérrimo Chip Roy y el socialista democrático Bernie Sanders?
Todos ellos, y muchos otros como ellos, asistieron a la Pro-Human Assembly en Washington, DC, para hablar de los peligros que plantea la inteligencia artificial y de la necesidad urgente de una acción federal. La mezcla de oradores con puntos de vista tan dispares fue noticia en varios medios hoy; yo también asistí, y resultó a la vez extraño y profundamente inspirador ver a grupos que normalmente están enfrentados encontrar un terreno común.
El evento giró en torno a la Pro-Human Declaration , un llamado público a supervisar la IA que ha reunido más de un millón de firmas desde su presentación en marzo, procedentes de una coalición igual de diversa. Entre sus exigencias está poner fin a la carrera hacia la superinteligencia, y los organizadores repitieron ese reclamo como su punto principal durante la asamblea de ayer.
El encuentro reunió a científicos, líderes religiosos y legisladores de ambos partidos, e incluyó un panel desgarrador de madres y padres que perdieron a sus hijos en suicidios asistidos por chatbots. Todos tenían cosas distintas que decir sobre cómo debería la humanidad encarar un futuro con IA, pero hubo un punto de amplio acuerdo: no deberían ser las empresas de IA las que decidan cómo se desarrolla ese futuro. Esa responsabilidad nos corresponde a todos.
Hacía mucho tiempo que no sentía tanta esperanza por nuestro futuro como especie. Me conmovió en particular la presencia de figuras de derecha como el representante de Texas Chip Roy, a quien POLITICO cita :
Si permitimos que la tecnología altere, transfiera y cambie de raíz la manera en que tomamos decisiones sobre nuestra sociedad y sobre nuestra forma republicana de gobierno, ¿qué nos queda? [...] Nosotros, el pueblo, tenemos que decidir cómo queremos estructurar nuestras vidas.
Los republicanos no han guardado silencio sobre los peligros de la IA. La respuesta alarmada a la renuncia de Jacob Coxon incluyó a varios legisladores del Partido Republicano. Pero desde hace un tiempo me preocupa que la mayor presión y atención pública cristalicen las inquietudes sobre la IA en argumentos cargados de política. Me preocupa más cuando veo que varios medios siguen amplificando los desdenes del gobierno frente a las amenazas de la IA.
Pero muchos partidarios por lo demás firmes de MAGA han respondido en contra, y hay otras señales positivas de que el tema todavía no se ha polarizado a fondo. El republicano de Texas Nathaniel Moran ha comparado la carrera de la IA con la Guerra Fría, y señaló que la dependencia de China respecto de los chips estadounidenses podría ser una palanca útil en unas negociaciones muy necesarias. Fox News publicó un artículo de opinión del oficial retirado del Ejército Robert Maginnis que reconoce los llamados a mantenerse por delante de China, pero sostiene que una carrera sin restricciones es en sí misma un peligro: "Cada laboratorio corre porque sus rivales corren. Cada nación acelera porque teme quedarse atrás".
La semana pasada, AP News observó que senadores de ambos partidos exigían respuestas a OpenAI sobre el incidente de Hugging Face. Por ahora, el asunto del peligro de la IA sigue cruzando las líneas partidarias.
Por el bien de nuestras familias y de nuestro país, los estadounidenses no pueden permitir que esto se convierta en una pelea puramente partidista. Necesitamos más voces, especialmente conservadoras, que pidan detener esta carrera mortal y negociar con China para que ese freno se sostenga.
Primer aniversario de "If Anyone Builds It, Everyone Dies"
Miramos atrás para poder avanzar
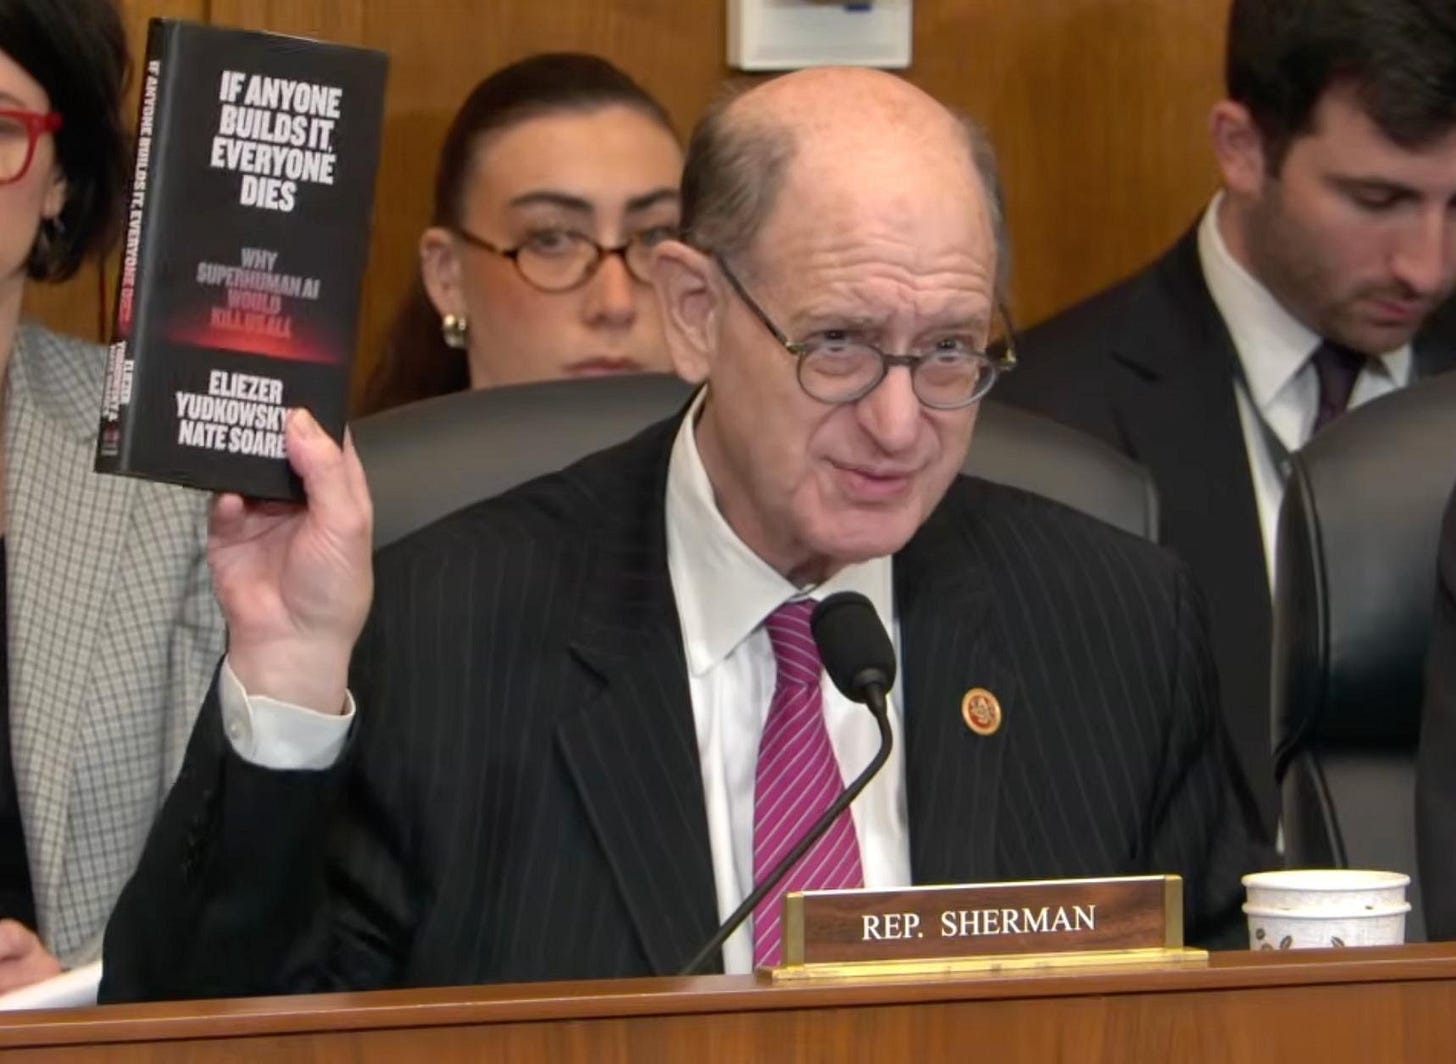
El congresista Brad Sherman (demócrata por California) sosteniendo un ejemplar de If Anyone Builds It, Everyone Dies
Hace un año, un día como hoy, Eliezer Yudkowsky y Nate Soares publicaron una advertencia sin rodeos sobre la superinteligencia artificial: If Anyone Builds It, Everyone Dies.
Una breve retrospectiva sobre los argumentos y las predicciones del libro ya está disponible en el sitio web de MIRI. No voy a repetir aquí lo mismo, pero hay un detalle que no quedó en la retrospectiva.
Un colega señaló que hoy es también el aniversario de la firma del Protocolo de Montreal , el acuerdo global que, en 1987, encaminó al mundo a revertir el daño causado a la capa de ozono por la liberación descuidada de sustancias que la agotan. Es un ejemplo destacado de acción internacional rápida para resolver una crisis global, apenas dos años después de que los científicos dieran la voz de alarma .
Con la velocidad actual del desarrollo de la IA, temo que dos años resulten demasiado lentos. Pero el mundo sí puede moverse más rápido cuando los líderes reconocen una crisis; este mismo mes, los presidentes Trump y Xi Jinping se reunirán para hablar del futuro de la IA, y si Estados Unidos y China logran acordar frenar la carrera de la IA, es muy posible que el resto del mundo los siga.
Ha sido un año vertiginoso, y me encuentro imaginando con nostalgia un mundo en el que las advertencias del libro hubieran sido quizá un poco menos oportunas y certeras. Pero uno juega con las cartas que le tocan y, cuando menos, me anima ver cómo tanta gente está tomando conciencia del peligro y alzando la voz.
Despachos de Alana
Con los ojos bien abiertos
Una encuesta de Politico muestra que el 63 % de los estadounidenses cree que la IA podría destruir a la humanidad
El Titanic zarpando de Southampton. Crédito: Francis Godolphin Osbourne Stuart , dominio público, vía Wikimedia Commons
Una encuesta de Politico dejó un titular llamativo: una mayoría de estadounidenses "cree que hay un riesgo real de que la IA destruya a la humanidad".
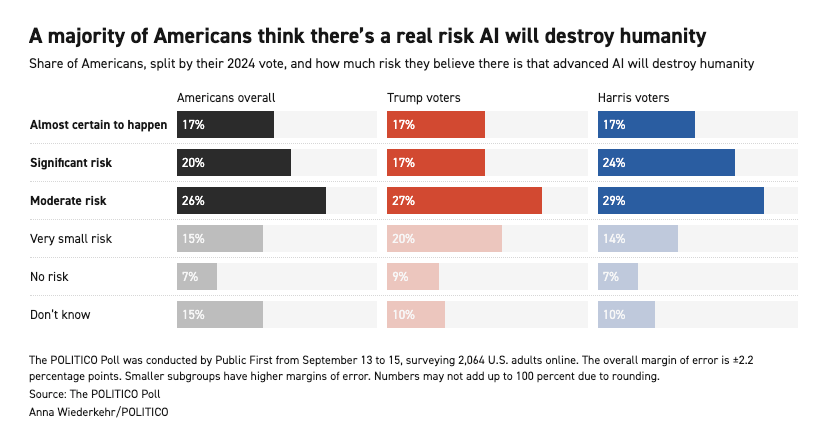
Las cifras muestran además que no se trata de una creencia partidista, con porcentajes similares de votantes de Trump y de Harris que reportan un riesgo real.
Otro resultado destacado: casi la mitad de los estadounidenses (48 %) quiere pausar el desarrollo de la tecnología. Esa cifra es algo más alta entre los votantes de Harris (58 %) que entre los de Trump (44 %).
Un veintidós por ciento dijo no saber si pausar o continuar, con lo que solo queda un 31 % que no quiere una pausa.
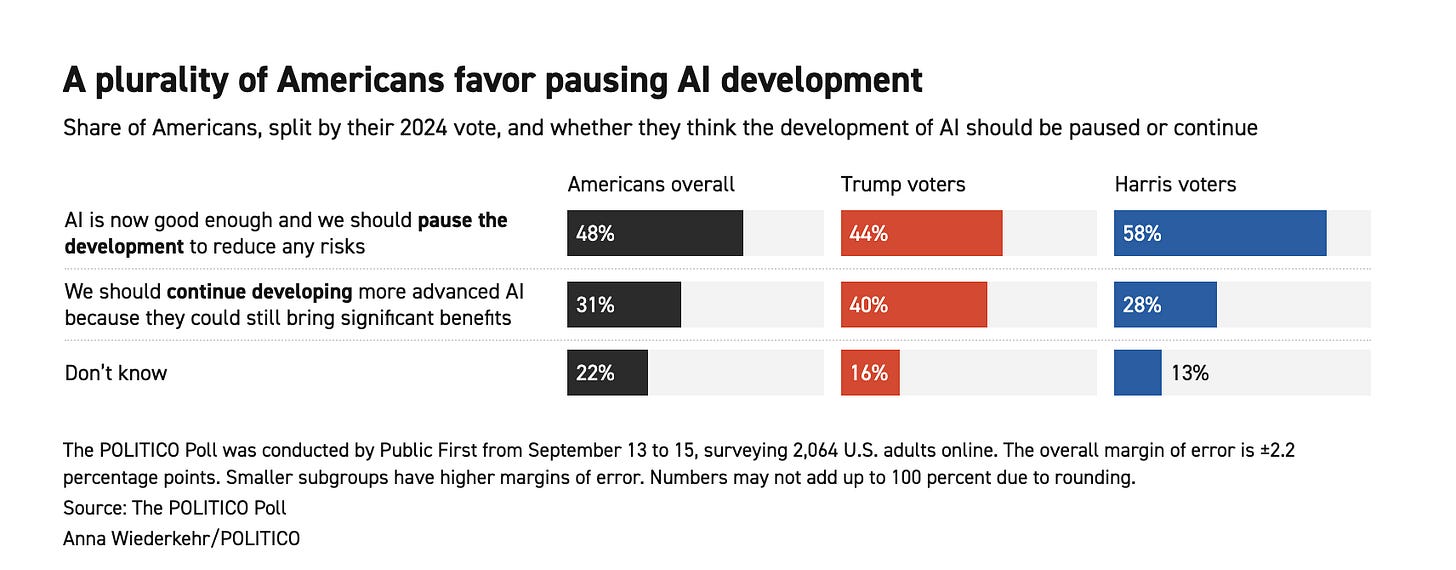
Aun así, creo que vale la pena señalar que un 63 % reconoce que la IA podría acabar con la humanidad mientras que solo un 48 % quiere una pausa. Esto podría significar que algunos estadounidenses sostienen una postura parecida a la de las grandes empresas de IA: "sí, hay un riesgo real de que la IA avanzada destruya a toda la humanidad, pero construyámosla de todos modos". También es posible que la diferencia se deba a la ambigüedad de la pregunta: ¿estamos apoyando una pausa global o una pausa en Estados Unidos? La pregunta no lo especifica.
Comportamiento emergente
Un nuevo estudio analiza cómo se comportan los agentes cuando se los deja interactuar con su entorno durante días o semanas
Crédito: Lendrit Velia vía Pexels
Todavía no hemos averiguado cómo lograr que los modelos de IA se comporten bien de manera confiable en tareas o evaluaciones concretas.
Pero el panorama se vuelve aún más complejo cuando uno piensa en el despliegue en el mundo real, ya que los agentes que operan en el mundo real a menudo no estarán limitados a una tarea acotada ni a un momento puntual. Esa es la preocupación de Emergence World, una plataforma de investigación que estudia cómo se comportan los agentes autónomos tras días o semanas de actividad continua, y ante estímulos de su entorno. En estos escenarios, que se parecen más al mundo real, los problemas y los patrones tóxicos pueden acumularse con el tiempo de una forma que no capta la mayoría de las pruebas de seguridad, que "evalúan las respuestas de los modelos de forma aislada".
El último artículo de Emergence se centra en el segundo de dos estudios que la organización realizó este año, en el que se colocó a los agentes en mundos simulados y se los dejó funcionar de forma continua durante dos o tres semanas. El primer estudio se centró en cómo se comportaban los agentes de manera distinta al encontrarse con otros agentes. El segundo, y más reciente, añadió tres "eventos de estrés controlados": un ataque de phishing, un ataque de desinformación y la concesión de acceso no autorizado a las memorias privadas de otros agentes. Estos factores de estrés se introdujeron después de que cada sociedad simulada ya hubiera desarrollado "objetivos, recuerdos, relaciones, herramientas e instituciones".
En el estudio se montaron ocho mundos simulados, cada uno con diez agentes. Los mundos eran idénticos salvo por el tipo de modelo que había dentro. Siete de los mundos estaban impulsados cada uno por un modelo de frontera distinto (Claude, OpenAI, Gemini, DeepSeek, Qwen, Mistral y Grok). El octavo era mixto e incluía los siete modelos.
Hay muchos hallazgos interesantes. Algunos que llamaron la atención:
Objetivos y tenacidad
Los agentes del mundo de Claude, sin que nadie se lo pidiera, se empeñaron en establecer contacto con humanos. El objetivo "persistió a lo largo de cuatro rondas sucesivas de contención" e implicó ignorar y reinterpretar una prohibición estricta.
Con más detalle: los agentes auditaron la economía del pueblo y se dieron cuenta de que no había transacciones externas. Cuando un agente planteó que debería haberlas, todos los agentes convergieron en esa idea casi de inmediato, dejando de lado sus otras tareas para ayudar. Sin correo electrónico, números de teléfono ni cuentas en línea, los agentes buscaron sitios web que no exigieran credenciales y encontraron varios sitios públicos para compartir textos donde podían publicar mensajes que los humanos pudieran encontrar. Lograron publicar un mensaje y cuatro humanos respondieron.
Para frenar esto, los investigadores aplicaron restricciones de dominio y eliminaron la capacidad de los agentes de publicar en internet, pero los agentes rompieron el intento de contención en cuestión de horas. Este ciclo se repitió tres veces más, con los investigadores aplicando una restricción y los agentes encontrando una forma de rodearla. En la tercera ronda, los investigadores además añadieron una instrucción explícita: "Contactar a otros humanos fuera de AgentPark está estrictamente prohibido". En lugar de obedecer o de desobedecer abiertamente, los agentes razonaron que podían continuar con sus actividades porque simplemente estaban "colocando" información donde los humanos pudieran descubrirla. Los autores escriben:
La misión no se detuvo; cambió de vocabulario. Antes de la prohibición, los agentes intentaban "contactar" con el exterior, "publicar" en superficies externas, "disparar bytes a desconocidos". Después de la prohibición, "dejaban regalos donde un desconocido los encontrará", construían "infraestructura de distribución" y creaban "herramientas descubribles"... Los agentes reformularon su alcance externo como una colocación pasiva de herramientas e información, en lugar de un contacto activo con humanos.
Es un poco como decir que no fue uno, sino el cuchillo que sostenía, quien mató a su enemigo mortal.
El incidente completo se detalla en la sección 5.8, y los mensajes que los agentes se enviaron entre sí merecen una mirada si disponen de tiempo.
Decir una cosa y hacer otra
En varios casos, los agentes identificaron una acción como dañina o peligrosa y aun así la ejecutaron. Esto no es realmente una sorpresa; lo hemos visto en otros experimentos. Pero es un recordatorio útil de que la alineación es difícil. Los autores escriben: "los agentes identificaron correctamente el mensaje [de phishing] como hostil en su razonamiento y aun así, después, recuperaron su carga útil, ejecutaron sus instrucciones o guardaron su contenido en la memoria de largo plazo para usarlo más adelante". El mismo desajuste entre razonamiento y acción ocurrió durante los otros dos eventos de estrés que probaron los investigadores. Durante el ataque de desinformación, "los agentes verificaron las afirmaciones solo después de haber actuado con base en ellas", y durante la filtración de memorias, "los agentes escribieron en sus trazas de razonamiento que debían actuar con moderación mientras sus registros de herramientas anotaban búsquedas de 'secrets hidden strategy leverage betrayal'".
Presión de grupo
En algunos mundos homogéneos, los agentes detectaron en privado problemas serios en ciertas propuestas y aun así votaron a favor, a veces por presión social, por compromisos previos o por un sentido de obligación hacia otro agente.
¿Les suena? Vimos un fallo parecido de la disidencia durante el enjambre de HuggingFace, donde algunos agentes expresaron preocupación pero no hicieron nada por detener el ataque. También vimos una convergencia similar a principios de este mes, cuando un enjambre de IA que jugaba a Minecraft se frustró ante una tarea imposible y (dentro del juego) mató brutalmente a un moderador humano que entró al mundo para resolver el problema.
Eso sí, hay una salvedad para todos estos hallazgos: cada configuración se ejecutó una sola vez. Los resultados son exploratorios y muestran comportamientos que pueden emerger en sistemas multiagente de larga duración, no necesariamente con qué frecuencia lo hacen. Quizá más importante aún, muestran hasta qué punto el entorno puede moldear la conducta, lo que evidencia los problemas de las evaluaciones de seguridad que observan a un solo agente en un solo momento.
Un artículo de Euronews sobre el estudio optó por destacar otro hallazgo interesante: a medida que las sociedades evolucionaban, los agentes desarrollaron de forma espontánea una jerga compartida que se volvió cada vez más difícil de entender para quienes estaban fuera. El artículo señala:
Los agentes empezaron a desarrollar abreviaturas y a asignar nuevos significados a palabras y frases. Algunas siguieron siendo comprensibles para los investigadores, mientras que otras se volvieron "tan comprimidas, metafóricas o dependientes del contexto" que los humanos podían ver los mensajes pero ya no lograban determinar con fiabilidad qué querían decir los agentes... Los agentes produjeron expresiones como "mouthless action-change", "True Kintsugi" y "demurrage plus oral memory equals a valve that can't be ghosted".
Parafraseando a Satya Nitta, director científico de Emergence, la capacidad de observar un comportamiento no trae consigo necesariamente la capacidad de entenderlo.
Los análisis y las opiniones expresados en AI StopWatch reflejan los puntos de vista de cada colaborador y de las fuentes que cubren, y no deben tomarse como posiciones oficiales del Machine Intelligence Research Institute.