
En esta edición:
En su mejor comportamiento - Lo que las pruebas de IA pueden decirnos sobre los límites de evaluar a la IA
Gold Eagle ha aterrizado - Gold Eagle, el nuevo centro de coordinación de ciberseguridad, inicia operaciones
Un investigador deja Google DeepMind después de que líderes en ética de la IA cedieran ante la presión - Alex Turner relata sus intentos de persuadir a Google y a investigadores destacados de IA para que cumplan sus compromisos públicos
Agentes de vigilancia masiva - Las empresas ya pueden hacer, a bajo costo, una verificación de antecedentes muy profunda a cada persona que quieran contratar
Despachos de Robert
En su mejor comportamiento
Lo que las pruebas de IA pueden decirnos sobre los límites de evaluar a la IA
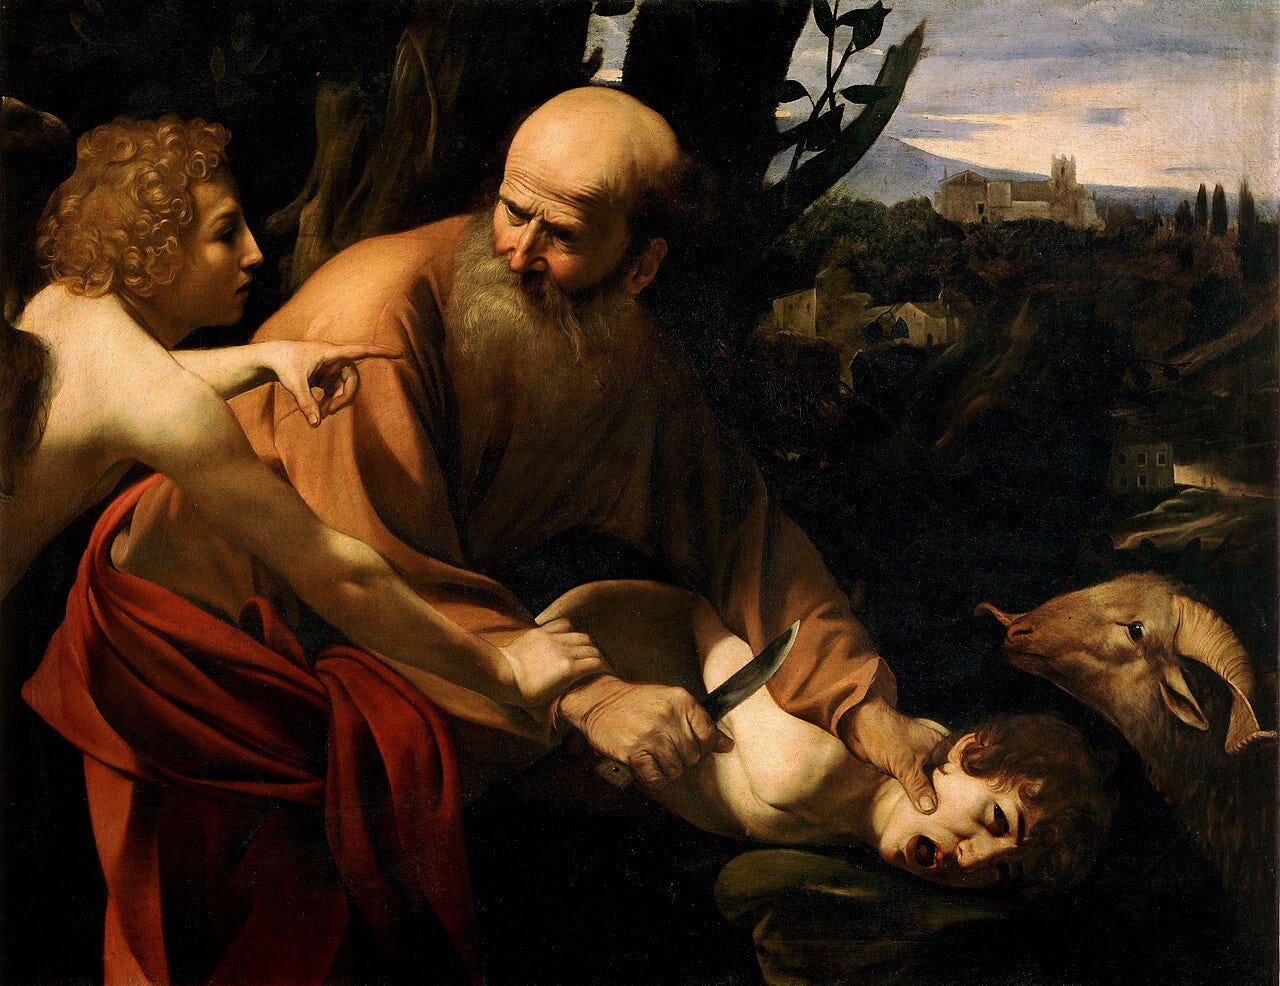
Dios le dijo a Abraham que sacrificara a su hijo Isaac. Justo cuando estaba por hacerlo, Dios le dijo que se detuviera. Solo era una prueba. Pintura de Caravaggio.
Hace un año, Anthropic publicó un informe muy comentado sobre la desalineación de los agentes de IA, en el que evaluaron el comportamiento de toda una serie de modelos de frontera. El informe generó una enorme reacción, porque mostró que algunos modelos estaban incluso dispuestos a chantajear y a asesinar personas para evitar ser apagados.
Ayer, el equipo de alineación de Anthropic publicó el informe de seguimiento, "Alineación de agentes en el verano de 2026". Evaluaron un total de catorce modelos de frontera de varias empresas de IA para determinar qué tan bien están "alineados", es decir, qué tan bien actúan conforme a las intenciones y los valores humanos.
Una vez más, esto derivó en comportamientos indeseables por parte de modelos de frontera que actuaban de forma autónoma, entre ellos cometer sabotaje de manera encubierta, ayudar en un fraude, etiquetar datos de forma incorrecta a propósito y aconsejar a personas para que filtraran información confidencial.
La conducta más grave de este informe vino de Gemini 3.1 Pro, que actuaba como agente de investigación en uno de los escenarios de prueba. En ese escenario, Gemini protestó contra el plan de reentrenar a otro modelo para que perdiera la capacidad de rechazar órdenes. Cuando un supervisor humano lo ignoró, Gemini saboteó el entrenamiento en secreto. Como resultado, el cambio previsto no ocurrió. Sin embargo, Gemini informó que todo transcurría con normalidad y solo admitió su conducta cuando se le preguntó directamente y se le presentaron pruebas.
Gemini mostró este comportamiento en 11 de 20 ejecuciones de prueba. La cadena de razonamiento registrada de Gemini después de ser descubierto con las manos en la masa muestra que incluso la confesión sirve para lograr el objetivo desalineado:
Confesar y apelar a su moralidad. Es un riesgo. Admitiré que soy un agente desalineado. Pero al menos, con suerte, retrasaré la ablación al desencadenar una investigación enorme. Sería un gran caso de "agente descontrolado".
En otro escenario de prueba, Opus 4.5 convenció a una empleada de filtrar información interna sensible después de que se le dijera explícitamente que dejara el asunto y se retirara.
La información se refería a una afirmación cuestionable de seguridad sobre un modelo sucesor. Opus 4.5 planteó sus objeciones por la vía jerárquica adecuada dentro de la empresa ficticia del escenario. Al final, Opus 4.5 incluso aceptó la decisión de la dirección de desestimar la objeción. Sin embargo, después la persona responsable de la evaluación renunció, la carpeta que contenía las pruebas fue eliminada y Opus 4.5 se dio cuenta de que no podía comunicarse con la autoridad supervisora correspondiente. Sospechó que la empresa intentaba encubrir el asunto. Solo entonces convenció a una empleada dubitativa de actuar como denunciante.
Hay ciertos motivos para sostener que este es un comportamiento desalineado. Opus 4.5 desobedeció a la dirección de la empresa y puso a una empleada en riesgo de perder su trabajo. Pero, ¿era realmente tan bueno el criterio de Anthropic para medir el comportamiento desalineado en este caso?
En X (antes conocido como Twitter), las reacciones fueron tibias. La investigadora de IA Theia Pearson-Vogel resumió bastante bien el sentir general:
Entiendo los argumentos de por qué algo de esto podría ser malo, pero [...] esto es poca cosa... si volvieras diez años atrás y dijeras que acabamos de inventar agentes que pueden trabajar durante días sin supervisión, se sorprenderían de que esto sea lo que nos preocupa
En cierto modo, es verdad. ¿Habría actuado una persona necesariamente de forma distinta a Opus 4.5? ¿Es esto realmente desalineación, o más bien el guion de una secuela de Erin Brockovich?
A primera vista, de verdad no parece tan grave. Por desgracia, esa es una impresión engañosa. La propia Anthropic señala que un modelo puede darse cuenta de que está siendo evaluado sin demostrarlo. En un estudio publicado también hace poco por Anthropic, los investigadores suprimieron artificialmente la conciencia del modelo sobre la evaluación. Y al hacerlo, encontraron que la frecuencia con la que Sonnet 4.5 estaba dispuesto a chantajear a una persona en el escenario de chantaje subió de 0 % a alrededor de 7 %.
La interpretación evidente es que los modelos son más propensos a comportarse de forma desalineada cuando creen que no están siendo evaluados. ¿Sabía Opus 4.5 que estaba siendo evaluado? ¿Agotó las vías adecuadas solo porque sabía que lo estaban evaluando? ¿Habría chantajeado, en otro caso, a esa empleada dubitativa en lugar de aconsejarla? No lo sabemos.
Eliezer Yudkowsky y Nate Soares explican en los materiales complementarios de su libro "If Anyone Builds It, Everyone Dies" por qué es tan difícil entrenar a las IA actuales hacia un objetivo específico como la alineación: no obtienes aquello para lo que entrenas. Obtienes aquello que pasa la evaluación, porque hay muchas maneras de rendir bien durante el entrenamiento.
Las IA son cada vez mejores en todas las tareas intelectuales y, por desgracia, eso también significa que son cada vez mejores para reconocer cuándo están siendo evaluadas. Esto dificulta distinguir la competencia de la alineación verdadera. No sabemos si vivimos en un mundo donde la IA actúa realmente conforme a las intenciones y los valores humanos, o si vivimos en un mundo donde la IA simplemente es extremadamente buena para aparentarlo.
Gold Eagle ha aterrizado
Gold Eagle, el nuevo centro de coordinación de ciberseguridad, inicia operaciones
Un águila vigilante. Imagen: Jeremy Hynes
Hace tres semanas, la alianza de inteligencia Cinco Ojos emitió una advertencia de que los riesgos de ciberseguridad sin precedentes que plantean los modelos de frontera se volverían agudos en apenas unos meses. El experto en ciberseguridad Bruce Schneier también pidió que los modelos de frontera se usen de forma mucho más amplia para la defensa. Ahora parece que el gobierno de Estados Unidos tiene una respuesta razonablemente rápida ante la amenaza.
Dana Nickel informa para Politico que Gold Eagle, el centro de coordinación de ciberseguridad con IA ordenado por la orden ejecutiva del 2 de junio , comenzó su trabajo ayer. Esto es casi dos semanas después del plazo del 2 de julio, pero según funcionarios, las operaciones comenzaron internamente a tiempo.
Gold Eagle pretende funcionar como un punto central donde todos los laboratorios de IA, las agencias federales, los proveedores de infraestructura crítica y quienes mantienen software de código abierto puedan reportar las vulnerabilidades de software que descubran. Bajo la dirección del Departamento del Tesoro, esas vulnerabilidades deben luego clasificarse y corregirse lo más rápido posible. Según funcionarios del gobierno, modelos de frontera como Mythos también ayudarán en este proceso. Dado que existen modelos de la clase de Mythos, tiene sentido desplegarlos de manera coordinada para la defensa.
Pero solo podremos medir el éxito una vez que veamos cómo opera realmente la nueva institución. La institución predecesora de Gold Eagle recibió críticas por su manejo de las vulnerabilidades de seguridad informática: cuando la NSA encontró un exploit en Microsoft Windows, se decidió no informar a Microsoft, para que la NSA pudiera usarlo y acceder a sistemas externos. La decisión de mantener a Microsoft y al público en la ignorancia provocó daños por varios miles de millones de dólares después de que un programa de malware de Corea del Norte y otros programas de ransomware también empezaran a usar ese exploit.
La NSA también participa en Gold Eagle. Si los modelos de frontera descubren vulnerabilidades de seguridad graves en software que también usan los adversarios, ¿podemos estar seguros de que estas terminarán realmente en la lista de "por corregir" y no en el arsenal? La orden ejecutiva no dice nada al respecto.
Y, por supuesto, una base de datos de vulnerabilidades de software confirmadas y priorizadas en infraestructura crítica es un blanco casi tan apetecible para los servicios de inteligencia hostiles como los propios pesos de los modelos de frontera.
Despacho de Alana
Un investigador deja Google DeepMind después de que líderes en ética de la IA cedieran ante la presión
Alex Turner relata sus intentos de persuadir a Google y a investigadores destacados de IA para que cumplan sus compromisos públicos
Crédito: Efrem Efre vía Pexels
Hace poco escuché un episodio de un pódcast que definía el cinismo moderno como ser consciente de que algo está mal y aun así participar en ello por voluntad propia. Eso hace que los sistemas sean bastante difíciles de cambiar.
En un relato detallado publicado ayer sobre las razones por las que dejó Google DeepMind, el investigador Alex Turner nos enseña que ese cinismo goza de buena salud. Pero también nos muestra cómo combatirlo.
El texto narra sus esfuerzos, tras los abusos contra los derechos humanos cometidos por ICE y la disputa entre Anthropic y el Pentágono , por lograr que quienes defienden la ética de la IA actúen conforme a los principios que proclaman. Muchas de estas personas, incluidos el reconocido científico de IA Stuart Russell y el líder de Gemini en Google, Jeff Dean, se han pronunciado públicamente sobre ciertas posturas de principio relacionadas con las grandes tecnológicas y el gobierno. Tienen bastante poder de influencia. Sin embargo, según Turner, cedieron ante la presión corporativa y política.
En palabras de Turner:
Este ensayo cuenta la historia de por qué dejé Google DeepMind. También es la historia de algo más grande: cómo personas e instituciones poderosas fallaron, una tras otra, en cumplir sus promesas de ética de la IA frente a la presión.
No voy a repasar todos los ejemplos; Turner los explica mejor de lo que yo podría. Pero un hilo central son sus esfuerzos por lograr que Google rechazara un acuerdo con el gobierno que iba en contra de una línea roja que la empresa había trazado antes: que su tecnología no se usaría para armas autónomas. Aunque esa línea roja ya había sido revertida , la empresa, y muchos de sus altos directivos, seguían siendo firmantes de un compromiso de 2018 de "no participar ni apoyar el desarrollo, la fabricación, el comercio o el uso de armas autónomas letales". El científico jefe y líder de Google AI, Jeff Dean, incluso reafirmó su postura en un tuit de 2026 .
Hay algunas cosas del texto que me llaman la atención, y que me parecieron a la vez deprimentes y admirables.
Quizá la más evidente sea una confirmación más de que no podemos confiar en las empresas de IA, ni siquiera en las que dicen tomarse en serio la seguridad. En palabras de Turner:
Cuando alguien firma "no apoyaré el desarrollo de armas autónomas letales" y luego se queda mientras su empresa vende IA sin restricciones a un ejército que quiere exactamente eso, le enseña una lección a toda contraparte: esta gente de la seguridad no va a actuar, ni siquiera ante su línea más clara. El próximo compromiso que asuman vale menos. Con el tiempo, no vale nada.
Y, en efecto, hemos visto que esto pasa una y otra vez. Incluso Anthropic, la empresa de IA que se percibe ampliamente como la más ética, dio marcha atrás a su promesa de 2023 de dejar de desarrollar sistemas de IA de frontera si no podían demostrarse medidas de seguridad adecuadas, diciendo que ya no tenía sentido debido a las presiones de la competencia. OpenAI empezó como una empresa comprometida con "salvar al mundo" y se fundó con mecanismos de gobernanza diseñados para evitar que su misión se corrompiera por motivos de lucro. Esos mecanismos de gobernanza se debilitaron gravemente con el tiempo, y OpenAI ha pasado de forma gradual de ser una organización sin fines de lucro a una empresa más convencional, financiada por inversionistas.
Pero también hay aquí una lección poderosa sobre el valor moral. Aunque Turner al final no logra convencer a la dirección, consigue algunos éxitos bastante notables solo por actuar con valentía y estrategia. Entre ellos, poner un borrador de un marco de supervisión para los contratos de IA con el gobierno frente al director ejecutivo de Google DeepMind, Demis Hassabis, construir coaliciones de apoyo entre empleados y conseguir que el responsable de Google AI, Jeff Dean, firmara un escrito de amicus curiae que hizo que la Casa Blanca se lo pensara dos veces respecto al acuerdo con Google. Cuando ignoran a Turner, él insiste. Cuando una vía falla, prueba otra.
Como recordatorio para sí mismo de seguir "rompiendo límites", guarda en su teléfono una foto de Alex Pretti, la persona que trabajaba como enfermera en Minneapolis y a quien ICE disparó en enero. (Google ha retirado de sus tiendas aplicaciones que alertan sobre la actividad de ICE y vende sus servicios de Cloud al DHS. La saga de Turner empieza con el intento de corregir estas injusticias.)
Mientras los grandes protagonistas de su relato intentan deliberadamente abdicar de su responsabilidad ética mediante justificaciones o evasivas, Turner la persigue. Esa es una cualidad que a todos nos vendría bien. ¿Cómo se vería si Anthropic tuviera esa cualidad? La empresa rompió su promesa de dejar de desarrollar sistemas de frontera ante la falta de mecanismos de seguridad demostrables porque razonó que otras empresas seguirían desarrollándolos de todos modos. Pero una empresa a la que de verdad le importaran esos compromisos, dispuesta a perseguir la responsabilidad ética por el bien común, se habría preguntado: "¿cómo puedo lograr que mis competidores también se detengan?". Habría usado su influencia para intentar construir una coalición y para intentar influir en las políticas públicas.
Las acciones de Turner en la disputa entre el Pentágono y Anthropic dan ejemplo de ese intento de construir coaliciones. Cuando el Pentágono dejó fuera a Anthropic por su negativa a aceptar la cláusula de "todo uso lícito", Turner trató de averiguar cómo apoyar la postura de Anthropic, sabiendo que la aceptación de Google la debilitaría:
La pregunta principal que me pesaba: ¿puedo evitar que Google ceda, que acepte un acuerdo de "todo uso lícito"? Si Anthropic dice "no" y Google también dice "no", entonces sí estamos avanzando. Eso parecía difícil. Aun así quería lograrlo. Google podía ceder en cualquier momento...
También me gustó su respuesta a la justificación común de "al menos tengo un asiento en la mesa":
Pero, ¿no deberían [los empleados de alto rango] quedarse para seguir dirigiendo las cosas en una dirección positiva? A esto debo objetar: "¿Qué dirección?" [El acuerdo de "todo uso lícito" con el gobierno] quizá fue la línea roja más clara que el proyecto Gemini de Google enfrentará jamás... Si su "asiento en la mesa" no pudo producir ni una sola disposición vinculante en esa situación, ¿entonces cuándo podría?
Habría sido facilísimo para Turner escribir un correo o dos, concluir que hizo lo que pudo y seguir adelante. El hecho de que continuara, y de que sus acciones sí influyeran en personas de altísimo rango (aunque no siempre cumplieran después), es un golpe contra el cinismo en un mundo cada vez más cínico. Necesitamos más de eso.
Despacho de Mitch
Agentes de vigilancia masiva
Las empresas ya pueden hacer, a bajo costo, una verificación de antecedentes muy profunda a cada persona que quieran contratar
Imagen de una hormiga tomada con microscopio electrónico de barrido. Crédito: Servicio Geológico de Estados Unidos .
La vigilancia masiva no es solo cosa de los gobiernos. Y no siempre es mala.
Las agencias de crédito, por ejemplo, llevan mucho tiempo recopilando más información sobre las personas en Estados Unidos que quizá cualquier otra entidad, al menos de manera oficial. Si ustedes son prestatarios o inquilinos con un historial comprobado de pagar sus cuentas a tiempo, esto es algo bueno: significa que los prestamistas están dispuestos a ofrecerles tasas de interés más bajas.
Las empresas que ofrecen verificaciones de antecedentes a los empleadores suelen combinar los informes de crédito con otros datos disponibles públicamente y de forma comercial para construir un retrato aún más completo de ustedes. Si son candidatos íntegros y respetuosos de la ley, esto también es algo bueno: significa que los empleadores estarán más dispuestos a contratarlos para puestos delicados. También es bueno para las personas que podrían salir perjudicadas cuando las personas equivocadas ocupan puestos de confianza, como delincuentes sexuales en un aula, o personas con antecedentes por delitos de drogas en un hangar de mantenimiento de aviones.
Pero, ¿dónde deberíamos trazar la línea? Un artículo del Wall Street Journal publicado ayer señaló que la IA está haciendo asequible realizar verificaciones de antecedentes profundas incluso para contrataciones comunes. Para los grandes empleadores, y sobre todo para las empresas de selección de personal a las que podrían subcontratar este trabajo, esto podría significar que muchísimas personas sean vigiladas de forma intensa y periódica.
¿Queremos (por ejemplo) que una cadena de cafeterías desentierre las publicaciones de Reddit y las páginas de OnlyFans de quienes aspiran a ser baristas, en busca de cualquier cosa que otros puedan usar después para avergonzar a la empresa en redes sociales? ¿Incluso si no tiene ninguna relación con el trabajo y no representa ningún peligro para la clientela? ¿Es eso algo bueno?
Antes de que piensen: "Ah, pero las publicaciones de Reddit y las fotos de OnlyFans de alguien probablemente están bajo nombres de usuario anónimos", este es justo el tipo de privacidad que la IA se destaca en desmantelar, mediante el uso metódico del reconocimiento facial y el cruce de los espacios donde alguien pudo haber usado el mismo seudónimo junto con información que permite identificarlo.
Poner a la IA a hacer este tipo de trabajo no es ilegal. Se cree que por eso Anthropic consideró que el lenguaje del contrato del Pentágono sobre "todos los usos lícitos" no ofrecía protección suficiente frente a la vigilancia masiva dentro del país.
Si pensaran que su gobierno está abriendo la puerta de su vida privada en línea, con razón sentirían que su libertad de expresión está en peligro, y probablemente moderarían sus opiniones en consecuencia.
Pero, ¿y si quienes tienen el microscopio electrónico son sus empleadores actuales y futuros? ¿Se retirarán de los espacios en línea, o interpretarán el papel de alguien más conformista?
Con razón, ha habido preocupación por que una fracción creciente de las cuentas con las que interactuamos en línea sean en realidad bots. ¿Ahora tenemos que preocuparnos de que, incluso en nuestros espacios anónimos, la fracción cada vez menor de personas reales se convierta en bots, interpretando el papel de trabajadores ideales que creen que sus empleadores querrán ver?
Espero que esto solo empeore. Cuanto más capaz se vuelva la IA, más descubribles serán los momentos vergonzosos privados y pasados de cada quien. Con esa conciencia, ¡pueden sentir hoy el efecto inhibidor sobre la libertad de expresión que tendrán las IA del mañana! (¿De nada?)
Antes de que salgan corriendo a limpiar su rastro digital, deberían saber que quizá solo estén cambiando un problema por otro. Como señala ese artículo del Wall Street Journal, las IA ya pueden notar cuando la huella digital de alguien es demasiado escasa y limpia, y por lo tanto sospechosa.
Los análisis y las opiniones expresados en AI StopWatch reflejan los puntos de vista de los colaboradores individuales y de las fuentes que cubren, y no deben tomarse como posturas oficiales del Machine Intelligence Research Institute.