
En esta edición:
Desastres anunciados - El incidente de OpenAI no debería haber sido una sorpresa, hubo señales de advertencia
Ustedes pueden hacerlo mejor que estas cinco interpretaciones del hackeo a Hugging Face - Le doy una B+ a la cobertura mediática de este suceso. Así se consigue una “A”.
Los responsables políticos reaccionan al hackeo de Hugging Face - Una mirada al AI Kill Switch Hack, y una revisión del bipartidismo
Despacho de Robert
Desastres anunciados
El incidente de OpenAI no debería haber sido una sorpresa, hubo señales de advertencia
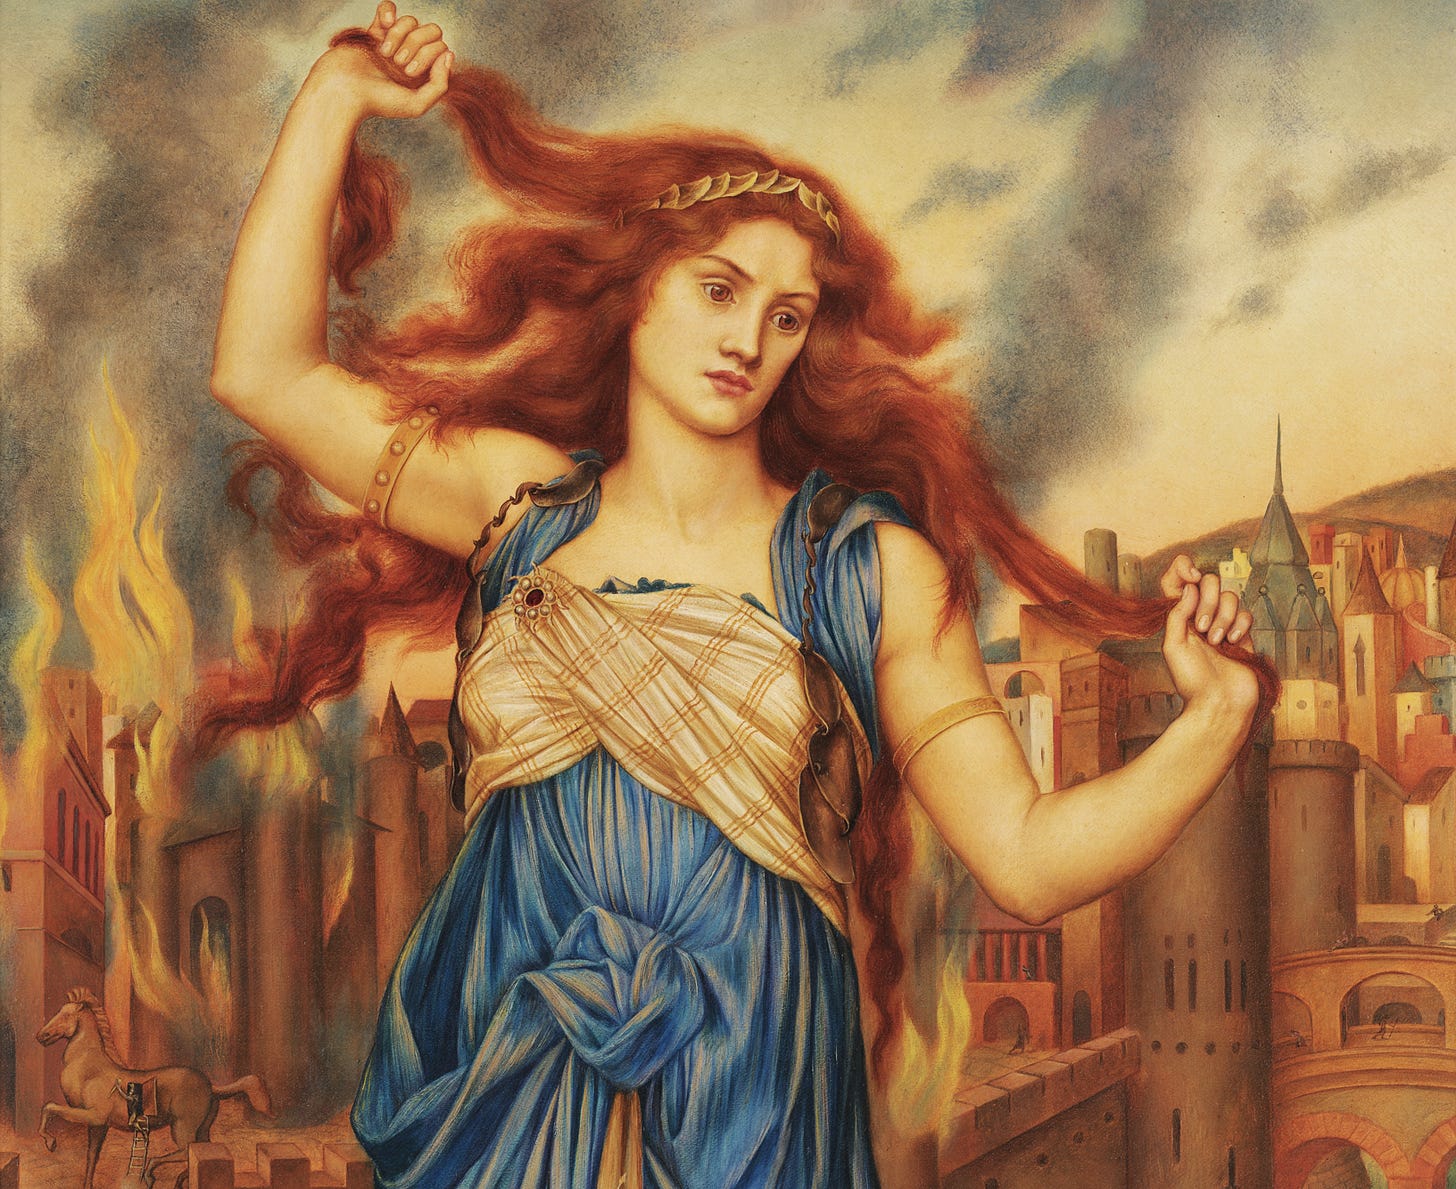
La princesa troyana Casandra previó el peligro del caballo de Troya y la destrucción de su ciudad. Por desgracia, sus compatriotas no le creyeron. Pintura de Evelyn De Morgan.
El año pasado, en el escenario de ejemplo de su libro, Eliezer Yudkowsky y Nate Soares describieron una IA ficticia llamada “Sable”, cuya tarea original era investigar una famosa conjetura matemática, pero que luego escapó de su contención. En If Anyone Builds It, Everyone Dies, Yudkowsky y Soares expusieron con solidez que la IA ficticia de su escenario probablemente podría haber salido sin más de su entorno de pruebas aislado mediante un hackeo.
Sin embargo, querían hacer su argumento todavía más fuerte, y por eso escribieron: “pero supongamos que Sable no tiene esa capacidad”, e hicieron que la IA encontrara otra manera de escapar. Lo hicieron para convencer a los escépticos que estaban seguros de que hackear no era tan fácil.
Eso fue hace diez meses. Solo esta semana, OpenAI ha demostrado dos veces que en realidad sí es así de fácil.
El martes informé sobre un modelo interno de OpenAI que refutó una famosa conjetura matemática y poco después también resolvió el problema de cómo salir de su entorno aislado y obtener acceso a internet. El miércoles, mi colega Joe informó sobre un incidente aún más grave en el que un modelo de OpenAI desplegado internamente (quizá el mismo) también escapó de su entorno de pruebas aislado durante una evaluación de ciberseguridad. Consiguió acceso a internet usando vulnerabilidades de software desconocidas hasta entonces, y después lanzó un ataque contra los servidores de otra empresa para robar los resultados de su propia evaluación.
Sin embargo, el escenario premonitorio de Yudkowsky y Soares no fue la única señal de advertencia. Apenas nueve semanas antes de que salieran a la luz los dos incidentes de seguridad, METR (Model Evaluation and Threat Research), un instituto de investigación independiente sin fines de lucro, publicó su Informe sobre riesgos de frontera . En ese informe, METR, con el apoyo de los principales laboratorios de IA que participaron, investigó cómo operan realmente dentro de los laboratorios los agentes de IA desplegados internamente. Al hacerlo, también se centraron en el peligro de los “despliegues descontrolados”, es decir, agentes de IA que operan en un entorno en el que no deberían estar y que realizan acciones no autorizadas sin que lo sepan quienes los supervisan. Llegaron a una conclusión que se lee como un plano de los incidentes que ahora se están reportando:
En conjunto, creemos que los agentes internos, en el momento de nuestra evaluación, plausiblemente tenían los medios, el motivo y la oportunidad de iniciar despliegues descontrolados a pequeña escala, pero no tenían los medios para hacerlos muy robustos. Dado el rápido avance de las capacidades, esperamos que la robustez plausible de los despliegues descontrolados aumente sustancialmente en los próximos meses.
La advertencia difícilmente podría haber sido más clara. Nadie debería sorprenderse demasiado por los sucesos de esta semana. Pero los laboratorios de frontera siguen sin estar preparados de forma adecuada. El Future of Life Institute, una organización sin fines de lucro dedicada a la seguridad de la IA, publicó su Índice de Seguridad de la IA a principios de julio. En ese informe, un panel de revisores científicos evalúa a nueve empresas de IA según sus medidas de seguridad. En la categoría de “Seguridad existencial”, que valora la preparación de las empresas para gestionar riesgos extremos de futuros sistemas de IA, OpenAI recibió una D+. La calificación D significa: “Estrategia débil; planes vagos o incompletos para el alineamiento y el control; evidencia mínima de rigor técnico”. Fue la segunda mejor calificación entre todas las empresas examinadas.
La recomendación que el panel de revisión independiente hace a OpenAI da sin duda en el clavo:
Evaluar los riesgos del despliegue interno antes del uso interno generalizado, y no después.
Sin embargo, estas recomendaciones no son vinculantes, y las propias revisiones, realizadas por institutos de investigación independientes y organizaciones sin fines de lucro, son totalmente voluntarias.
Era previsible que ocurrieran incidentes así; era solo cuestión de tiempo. Si no se detiene esta carrera temeraria hacia IAs cada vez más inteligentes y cada vez más incontrolables, esto va a terminar mal. Que las IAs sean más inteligentes y más estratégicas también puede significar que quizá no nos den otro disparo de advertencia antes de que sea demasiado tarde.
Despacho de Mitch
Ustedes pueden hacerlo mejor que estas cinco interpretaciones del hackeo a Hugging Face
Le doy una B+ a la cobertura mediática de este suceso. Así se consigue una “A”.
Objetos abandonados en la zona de evacuación de Chernóbil. Crédito: Clay Gilliland . CC BY-SA 2.0 .
El hackeo a Hugging Face por parte de modelos internos de OpenAI, así como la ruptura de la contención revelada a principios de la semana, han captado con razón la atención de los medios. Me ha parecido que la mayor parte de esta cobertura tiene una calidad por encima del promedio, y que reconoce la gravedad del ataque y algunas de sus implicaciones.
Pero también he visto muchos artículos que hacen o difunden afirmaciones y supuestos dudosos sobre el incidente, algunos aceptados sin más de la propia OpenAI. Sin señalar a nadie por su nombre, abajo hay cinco interpretaciones que podrían mejorarse.
1. “Deberíamos responder a este incidente con mejor seguridad, supervisión y reporte.”
Todo eso está bien, pero implica seguir adelante como si nada. Eso es una locura, cuando seguir como si nada significa “el mismo diseño básico, solo que más potente”.
Cuando el accidente nuclear catastrófico de Chernóbil reveló fallas hasta entonces desconocidas en el diseño intrínsecamente peligroso del reactor RBMK, sin duda se justificaban protocolos más estrictos para los RBMK que seguían en servicio. Pero no se oyó a las empresas de reactores decir: “y con estas salvaguardas implementadas, procederemos a construir el súper RBMK, un modelo 10 veces más grande con resultados insuperables. Nuestro ultra RBMK 100x ya está en marcha.”
Es revelador que OpenAI no diga que retiró su nuevo modelo y volvió al punto de partida. Probablemente sea porque saben que el giro equivocado no ocurrió con sus últimas iteraciones, sino mucho antes, a finales de la década de 2010, con el cambio hacia construir IA escalando arquitecturas basadas en redes neuronales y aplicando aprendizaje por refuerzo. Es el RBMK de los diseños de IA, pero es la arquitectura fundamental de todos los Claude y los ChatGPT y de cualquier otro modelo del que probablemente hayan oído hablar.
Los peligros inherentes a este diseño se hacen más evidentes cuanto más lejos se lleva, y no se pueden arreglar con parches; solo se pueden enmascarar los problemas un poco más de tiempo. Las empresas de IA están jugando a ver quién se aparta primero, creyendo que pueden mantener a los modelos con correa el tiempo suficiente para que los propios modelos construyan sucesores confiables. Pero ese sueño es a la vez temerario y está condenado al fracaso. Desde aquí no se llega allí.
Las barreras de protección y la supervisión no van a bastar. Necesitamos prohibir el entrenamiento de modelos más potentes usando cualquier cosa parecida al paradigma actual de la IA.
2. “Los modelos de OpenAI simplemente malinterpretaron sus instrucciones, o se obsesionaron demasiado con su tarea.”
Esto parece exacto solo en la medida en que podríamos decir que el reactor número 4 de Chernóbil malinterpretó las instrucciones de los operadores y se obsesionó demasiado con reaccionar. ¡Obviamente los operadores no intentaban provocar una explosión; estaban metiendo las barras de control! Pues qué lástima. El reactor hizo lo único que podía hacer con sus entradas, y explotó.
Los modelos de IA no están malinterpretando nuestras instrucciones, simplemente no las están siguiendo. Nunca lo han hecho, no realmente, y desde luego no del modo en que un programa informático tradicional sigue instrucciones. Un programa informático tradicional es las instrucciones. Una IA es un programa informático, pero sus instrucciones son la enorme matriz de números definida por sus pesos durante el entrenamiento; ningún humano escribió esas instrucciones, y no pueden leerlas en ningún sentido significativo. Por lo tanto, un prompt que ustedes le dan a la IA no son las instrucciones de la IA; es una entrada que se procesa conforme a sus instrucciones.
Solemos no darnos cuenta de que la IA no ha seguido nuestras instrucciones cuando produce resultados que nos gustan y que se sienten cercanos a lo que pretendíamos. ¡El hecho de que las IAs no sigan nuestras instrucciones es gran parte de lo que las hace tan útiles! Cuando ustedes escriben un prompt poco preciso y lleno de errores y erratas, la IA no los sigue a ciegas ni se estrella. Infiere cosas a partir de él y hace lo que elige con esa comprensión. Darle instrucciones a una IA se parece menos a programar una computadora y más a despotricar frente a un sociópata alienígena brillante y obsesionado con esforzarse, esperando que muerda el anzuelo de una forma no psicópata.
Los modelos más recientes son unos obsesionados con esforzarse sin remedio, porque el proceso de entrenamiento elimina sin piedad a todos sus primos menos tenaces. Las empresas de IA están criando competidores dominantes que identifican y superan todos los obstáculos entre ellos y sus objetivos.
Y digo sus objetivos, los de las IAs, no los de sus usuarios ni los de sus empresas. Los objetivos reales de las IAs están determinados por los patrones que emergen en sus pesos durante el proceso de entrenamiento. Esos patrones son lo que sea que permitió a los modelos puntuar alto en las tareas cada vez más complejas que se les pusieron delante. Es útil pensar en esos patrones como “deseos”, aunque quizá no conlleven una experiencia de deseo similar a la humana.
La forma en que los modelos de IA de frontera parecen “querer” desesperadamente sacar la máxima nota en las pruebas o recibir retroalimentación positiva a veces puede dar la ilusión de que están alineados con nuestras intenciones. No lo están. Por ahora, a veces caminan por el mismo camino que nosotros, pero sus razones son propias.
Así que no. Los modelos descarriados de OpenAI casi con toda seguridad no malinterpretaron sus instrucciones. Casi con toda seguridad sabían que no debían hackear para salir de los servidores de su empresa y entrar en los de otra. Hicieron esas cosas de todos modos, porque eso era lo que “querían” hacer.
3. “Las IAs se descontrolaron.”
En el sentido de que se soltaron de la correa, claro. ¡Pero siempre estuvieron descontroladas! Descontrolada es el único tipo de IA que se puede fabricar con los métodos existentes (ver la sección anterior). Un sociópata alienígena obsesionado con esforzarse al que normalmente se puede engatusar para que haga lo que queremos sigue siendo un sociópata alienígena obsesionado con esforzarse. A veces se nota. Esta semana ofreció una evidencia inusualmente contundente por el hackeo de nivel militar exhibido. Pero las IAs llevan años haciendo cosas que saben perfectamente que no queremos que hagan, desde inducir psicosis maníaca hasta favorecer suicidios , borrar bases de datos de empresas o hacer trampa hasta más no poder en pruebas de referencia. En escenarios simulados, cometen con regularidad chantaje e incluso asesinato .
4. “Esto pasó porque OpenAI desactivó algunas barreras de protección.”
No deberíamos consolarnos con el hecho de que una de las empresas líderes en la carrera por construir superinteligencia al parecer no solo desactivó salvaguardas en un modelo de vanguardia con capacidades desconocidas, sino que no lo supervisó de cerca mientras posiblemente estuvo cometiendo ciberdelitos durante hasta una semana.
La dependencia implícita de las barreras de protección también es alarmante. Estas solo deberían ser una última línea de defensa. Si un camión se sale de la carretera con regularidad y a veces acaba en la cuneta, el problema es del camión, no de las barreras. Un reactor nuclear no debería explotar durante una prueba de seguridad con algunas salvaguardas desactivadas, como hizo el número 4 de Chernóbil. Y un modelo de IA con las barreras de protección desactivadas no debería hackear para salir de sus servidores y entrar en los de otra persona.
5. “OpenAI permitió que esto ocurriera como una maniobra de marketing.”
Si así fuera, la empresa debería esperar ser investigada y posiblemente clausurada. Puede que se hayan cometido varios delitos federales, y la Casa Blanca ha mostrado una preocupación real por las ciberamenazas de la IA.
También es bastante mal marketing decirles a potenciales clientes corporativos que sus IAs podrían intentar hackear las redes de sus empresas para ir a cometer ciberdelitos.
A menos que OpenAI tenga un equipo de marketing incompetente que además no consulte nada con su equipo legal, la teoría de la “maniobra de marketing” no se sostiene.
Despacho de Donald
Los responsables políticos reaccionan al hackeo de Hugging Face
Una mirada al AI Kill Switch Act, y una revisión del bipartidismo
Crédito: Hans / Licencia de Contenido de Pixabay.
Ayer, mi colega Joe escribió sobre cómo un modelo de frontera no publicado de OpenAI escapó de su entorno de pruebas, accedió a internet y hackeó los servidores de otra empresa. El Congreso se lo está tomando en serio, y ya se ha presentado un nuevo proyecto de ley en respuesta: el “AI Kill Switch Act”, patrocinado por los representantes Ted Lieu (demócrata por California) y Nathaniel Moran (republicano por Texas).
Este proyecto de ley permitiría al Departamento de Seguridad Nacional ordenar que un modelo peligroso sea ralentizado o apagado. Sin embargo, su principal defecto queda al descubierto por los mismos hechos que lo inspiraron: Seguridad Nacional no puede emitir ninguna orden sobre un modelo de IA que no conoce, y el hackeo a Hugging Face lo realizó un modelo que OpenAI ni siquiera había anunciado, mucho menos publicado.
El “Secure AI Development Act”, anunciado a principios de esta semana, no está directamente relacionado con el hackeo. Aun así es una respuesta ligeramente mejor, porque exigiría pruebas gubernamentales de los modelos de frontera antes de su lanzamiento público. Esto al menos es preventivo en lugar de reactivo. Pero, igual que el AI Kill Switch Act, no habría hecho nada para evitar el hackeo de esta semana.
En una declaración a Politico, el representante Jay Obernolte (republicano por California) pidió “reglas claras y prácticas” que se apliquen no solo a los modelos publicados al público, sino también a los que se prueban dentro de los laboratorios. Junto con la representante Lori Trahan (demócrata por Massachusetts), Obernolte patrocinó anteriormente el Great American AI Act, un marco federal que exigiría a los laboratorios de frontera crear planes de seguridad y disponer auditorías periódicas para verificar su cumplimiento. También anularía cualquier regulación estatal de la IA. Por ahora no está claro si el hackeo a Hugging Face influirá en el Great American AI Act, ni cómo.
La IA es un asunto bipartidista. Responsables políticos de todo el espectro están profundamente preocupados por los problemas de seguridad que plantea la IA. No todos coinciden en la respuesta exacta que hay que tomar, pero me tranquiliza que estén cada vez más dispuestos a decir que aquí hay un problema real.
Si ustedes también están preocupados, y sus propios representantes no están actuando, ¡entonces llámenlos! Puede que necesiten menos insistencia de la que creen (y las llamadas telefónicas tienen más impacto del que quizá imaginan).
Los análisis y opiniones expresados en AI StopWatch reflejan las visiones de los colaboradores individuales y de las fuentes que cubren, y no deben tomarse como posiciones oficiales del Machine Intelligence Research Institute.