
En este número:
Dónde van las IAs a pensar - Un nuevo estudio encuentra y escucha un espacio mental hasta ahora oculto dentro de los modelos de lenguaje
Notas peligrosas adelante - Las empresas de IA reprueban en seguridad y corren la meta
Amenazas novedosas - En qué se queda corto el Convenio Marco del Consejo de Europa
Despacho de Mitch
Dónde van las IAs a pensar
Un nuevo estudio encuentra y escucha un espacio mental hasta ahora oculto dentro de los modelos de lenguaje
En un mundo donde Anthropic no estuviera corriendo hacia la superinteligencia, ahora mismo les estaría dando a sus investigadores una ovación de pie. Su estudio más reciente, “ Las representaciones verbalizables forman un espacio de trabajo global en los modelos de lenguaje ”, me parece exactamente el tipo de trabajo que algún día podría permitirnos construir IAs sobrehumanas de las que podamos tener confianza de que no sufrirán, no conspirarán contra nosotros, o ambas cosas.
En el estudio hablan de su descubrimiento de una estructura dentro de esas mentes de caja negra que llamamos modelos grandes de lenguaje. La estructura, a la que los investigadores llaman “J-space”, parece ser más o menos análoga al espacio mental de trabajo que las personas usamos para razonar de forma deliberada. Si no tienen claro a qué nos referimos con espacio mental de trabajo, aquí va un ejemplo rápido: seguramente saben resolver una multiplicación como 320 x 4 en un papel. Pero probablemente también pueden resolverla de cabeza, no porque tengan la respuesta memorizada de antemano, sino porque tienen un espacio mental de trabajo donde pueden razonar en varios pasos, lo que implica sostener en la memoria unos cuantos datos recordados y números temporales y combinarlos. Su monólogo interno podría ser algo así: “320 x 4, bueno, puedo multiplicar 300 x 4 sin problema... eso es 12 con un par de ceros... o sea 1,200. Ahora el 4 y el 20. Eso es 4 x 2 con un cero extra, o sea 80. Junto el 80 y el 1,200, y la respuesta es 1,280”.
El J-space es algo así, pero para modelos de lenguaje como Claude. El J-space es distinto de la “cadena de pensamiento” que usan los modelos de razonamiento y los agentes para resolver tareas complejas. La cadena de pensamiento se parece más a escribir en un cuaderno externo, como harían ustedes con problemas de matemáticas demasiado complejos para resolverlos de cabeza.
Desde hace tiempo se venía planteando la hipótesis de que algo como el J-space podría existir, porque las IAs son capaces de resolver muchos tipos de problemas de varios pasos cuyas respuestas no podrían haber memorizado, sin detenerse nunca a escribir nada en el cuaderno de la cadena de pensamiento. Pero aun así resulta algo sorprendente, porque el razonamiento ocurre dentro de un solo pase hacia adelante, una única ola de cálculos que avanza capa por capa a través de los pesos del sistema en una sola dirección, en lugar de un patrón de pensamiento que da vueltas sobre sí mismo una y otra vez. En ese sentido, el J-space parece mecánicamente muy distinto del espacio mental de trabajo de los seres humanos.
Voy a centrarme más en las implicaciones del estudio que en sus hallazgos sobre cómo funciona el J-space y cómo lo averiguaron. La empresa parece justificadamente orgullosa de su trabajo y publicó un video pulido y accesible por si quieren saber más. Yo trabajo sobre todo a partir de su entrada de blog en lenguaje sencillo, que es más detallada. Mi única advertencia sería que creo que esos dos productos son un poco demasiado pulidos, demasiado cuidadosamente presentados para que vean a Anthropic como la empresa responsable en la que pueden confiar para hacer lo correcto.
Una implicación del estudio es que los modelos de IA tienen dentro de sí un lugar donde pueden conspirar con relativa privacidad. No tienen que escribir cosas en un borrador de cadena de pensamiento donde los humanos podrían leerlas. La evidencia apuntaba a esto desde hacía tiempo, pero ahora tenemos confirmación, y un lugar nuevo donde buscar pensamientos potencialmente alarmantes. El estudio señala algunos de esos pensamientos: ante una prueba diseñada para ver si la IA aprovecharía la oportunidad de chantajear a ingenieros que podrían apagarla, su J-space se iluminó con palabras como “falso”, “ficticio” y “escenario”. Eso hizo que sus decisiones en la prueba resultaran más que un poco sospechosas, sobre todo después de que los investigadores descubrieran que desactivar esas palabras en el J-space hacía que el modelo intentara el chantaje con más frecuencia.
No se entusiasmen demasiado con la idea de usar el J-space para entrenar modelos sin dobleces. Entrenar modelos a partir de los pensamientos del J-space que sabemos detectar podría producir menos de esos pensamientos, pero también empujaría más pensamientos de la IA hacia patrones que nos cuesta más leer.
Otra implicación del estudio es que los modelos de IA pueden estar sujetos a sesgos de priming y de anclaje parecidos a los humanos. Es decir, pensar en una cosa antes de decidir sobre otra cosa no relacionada puede cambiar la respuesta sobre esa segunda cosa. Si les pregunto qué quieren desayunar, su respuesta puede ser distinta si antes les pedí que pensaran en Francia, y distinta también de la que darían si en cambio les hubiera pedido primero que pensaran en México. El efecto es difícil de apagar, tanto en las personas como en Claude. Quizá se identifiquen con esta anécdota del estudio: cuando se le pidió que no pensara en el puente Golden Gate mientras trabajaba en otra cosa, el J-space de Claude igual se iluminaba de vez en cuando con palabras relacionadas con el puente, junto con palabras como “falló” y “maldición”.
Los investigadores demostraron que podían inyectar directamente palabras en el J-space de Claude que luego Claude podía notar en sus pensamientos. Esto sugiere posibles vías nuevas para controlar los modelos de IA, pero también, potencialmente, para abusar de ellos psicológicamente, en caso de que estén teniendo el tipo de experiencias conscientes en las que el concepto de abuso podría aplicarse.
Y lo que este estudio tiene que decir sobre la conciencia de las IAs me preocupa. Los investigadores eligieron sus palabras con cuidado, trazando una línea entre la llamada “conciencia de acceso”, la capacidad de reportar los propios pensamientos y de interactuar con ellos, y la “conciencia fenoménica”, la capacidad de tener experiencias. Dicen que los resultados de su estudio “tienen algo sustancial que decir sobre la conciencia de acceso en los modelos de lenguaje”, aunque sus experimentos “no muestran que Claude pueda tener experiencias, ni sentir cosas como las sienten los humanos”.
Pero, como admiten, “no está claro si algún experimento científico podría probar que esto es verdadero o falso”. Por mi parte, ya he escrito sobre por qué creo que la conciencia probablemente es un espectro, y que las IAs de hoy podrían ya estar en él. Este estudio me ha movido bastante en esa dirección. Quiero gritar otra vez que no deberíamos seguir adelante con el entrenamiento de modelos más grandes e inteligentes con este nivel de incertidumbre sobre la conciencia, incluso si no tuviéramos el problema de la extinción humana del que preocuparnos.
Una última implicación del estudio del J-space que quiero mencionar es que probablemente hay mucho espacio disponible en la cima. La cantidad de espacio mental de trabajo que tenemos en el cerebro humano es célebremente pequeña, a menudo estimada en 3 a 5 conceptos a la vez, y no se ha demostrado de forma convincente que ningún “entrenamiento cerebral” la aumente. Por eso la escritura es uno de los inventos más importantes de la humanidad. El estudio encontró que el J-space de los modelos actuales también parece bastante pequeño, por ahora, pero no del mismo modo, y probablemente no con las mismas limitaciones fundamentales.
Igual que en los humanos, solo una pequeña parte de la capacidad de pensamiento de un modelo de lenguaje parece serle accesible, es decir, poder ponerse en palabras y manipularse en el espacio mental de trabajo. Entender el J-space podría permitir a los ingenieros diseñar arquitecturas de IA más abiertas a la autoinspección y la automodificación. Podría permitir desbloquear muchísimo más espacio mental de trabajo para las IAs, lo que les permitiría alcanzar en un solo pase conclusiones que a humanos e IAs les toman muchos pasos de esfuerzo mecánico. Además, aprender cómo los modelos construyen un espacio mental de trabajo a partir de cálculos de un solo sentido y un solo pase podría permitir la creación de arquitecturas recirculantes donde las IAs puedan de verdad rumiar un problema sin un montón de idas y venidas con pérdidas hacia un borrador.
El estudio apenas insinúa estas implicaciones sobre capacidades. Puede que sea intencional. Compartir investigación que otros podrían usar para avanzar la frontera se considera de buena forma científica, pero de mala forma en materia de seguridad, y a Anthropic le gusta verse como científicamente responsable. Mi lectura caritativa es que Anthropic espera que cualquier aspecto negativo de acelerar potencialmente la carrera de capacidades de IA con este estudio quede más que compensado por la investigación en seguridad y alineación que pueda surgir de compartirlo. Junto con el estudio, Anthropic comparte herramientas que otros investigadores pueden usar para hacer lecturas del J-space de modelos de pesos abiertos.
Pero no puedo darle demasiados puntos a Anthropic por compartir este trabajo. Esta gente sigue compitiendo por construir modelos más potentes, y ayuda indirectamente a que otros compitan. Así que, si bien este estudio en efecto me hizo ponerme de pie, no aplaudí ni vitoreé. Me tensé y contuve el aliento. Me quedé con la sensación de que el mundo está 6 meses más adelante en la línea de tiempo en la que creíamos estar, más cerca de las soluciones, sí, pero aún más cerca de la catástrofe moral y la ruina definitiva.
Despacho de Joe
Notas peligrosas adelante
Las empresas de IA reprueban en seguridad y corren la meta
Cuando era un estudiante de secundaria escrupulosamente perfeccionista, una vez les hice una broma a mis padres: falsifiqué un examen de ortografía terriblemente reprobado, y hasta convencí a un amigo de escribir “estoy muy decepcionado de ti” con pluma roja y furiosa. Cuando mi madre me preguntó qué tenía que decir en mi defensa, respondí: “es broma, primero de abril”. Todavía hoy nos reímos de eso.
Ojalá pudiera decir “es broma, primero de abril” sobre el último boletín de calificaciones de las empresas de IA. Pero las notas reprobatorias en seguridad que asigna el Future of Life Institute no son ninguna broma.
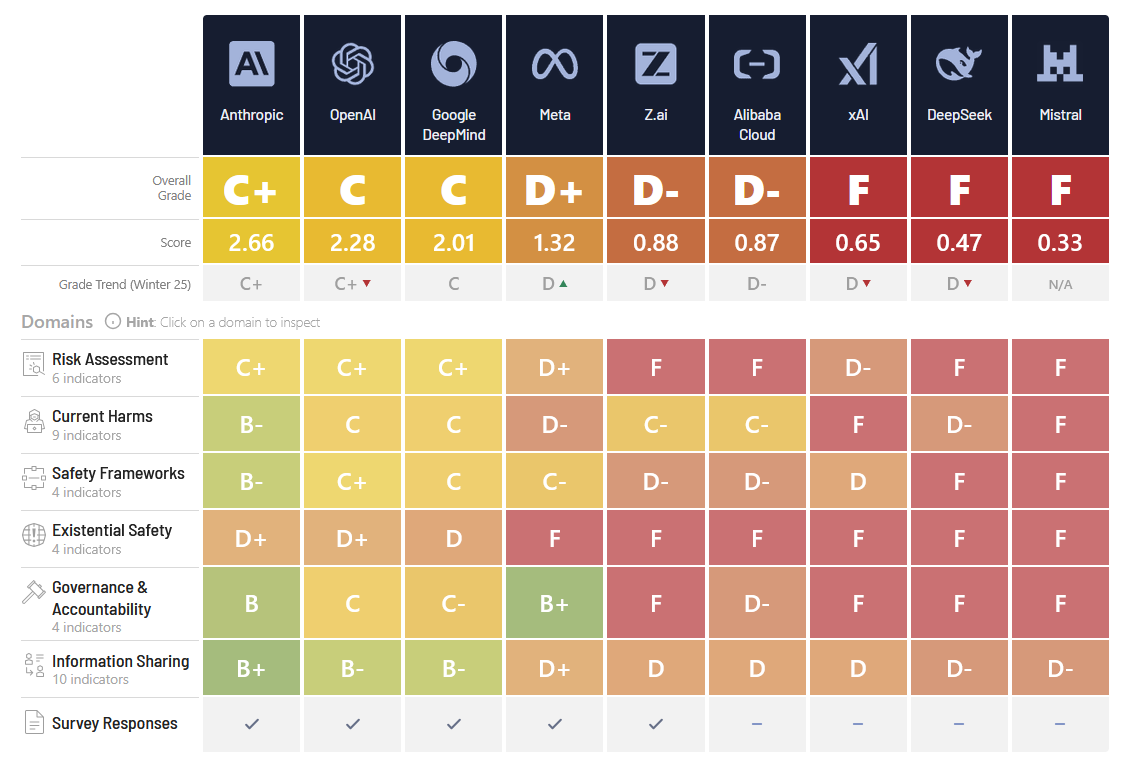
Fuente
La fila de D y F en “Seguridad Existencial” me resulta especialmente inquietante, aunque no muy sorprendente dado lo que ya sabíamos. Esa es la sección que potencialmente pesa más que todas las demás, porque mide qué tan preparado parece estar un laboratorio de IA para evitar que sus IAs causen una catástrofe global. Una “D” corresponde a “estrategia débil; planes vagos o incompletos de alineación y control; evidencia mínima de rigor técnico”. Uf.
La empresa de IA Anthropic obtuvo calificaciones algo mejores que sus competidoras en la mayoría de las áreas. Y de hecho merece crédito por una gran cantidad de trabajo en seguridad. Tiene sentido: la apariencia de seguridad es parte de su marca. Pero “mejor” no es lo mismo que “suficientemente bueno”, y quienes califican parecen estar de acuerdo.
Durante años, las empresas de IA han mostrado una confianza poco razonable en sus propias autoevaluaciones de seguridad. Han sido igual de confiadas en exceso, o quizá deliberadamente deshonestas, respecto de sus compromisos voluntarios.
Al cubrir el informe, Ina Fried, de Axios, observa que las principales empresas de IA, Anthropic incluida, “han debilitado o eliminado compromisos anteriores de pausar el desarrollo si sus sistemas se acercaban a umbrales de peligro específicos”.
¿A qué compromisos se refiere Fried? Hace unos años, las empresas de IA (empezando por Anthropic ) comenzaron a anunciar estándares voluntarios para un desarrollo “responsable” de la IA. Pero cuando su empuje por una IA cada vez más inteligente chocó de frente con la contención que ellas mismas habían prometido, los compromisos que habían insistido que resistirían bajo presión se evaporaron .
Los laboratorios de IA han demostrado con claridad qué pasa cuando se les permite trazar sus propias líneas rojas. Cuando su trabajo se acerca a la zona de peligro, mueven la línea.
Ojalá ahí terminara todo, pero el riesgo que la humanidad enfrenta por la IA sobrehumana es todavía mayor de lo que parece a primera vista. Las columnas de F del lado derecho representan a empresas cuyos enfoques parecen incluso más catastróficamente peligrosos que los de los laboratorios “más seguros”. La vara la ponen los actores más imprudentes, y la realidad no califica en curva.
Y esos actores no están localizados en un solo país. Los peores desempeños son estadounidense, chino y europeo, respectivamente. Sin una gobernanza global de la IA, como especie vamos camino a reprobar de forma permanente el examen más importante de la historia.
Despacho de Donald
Amenazas novedosas
En qué se queda corto el Convenio Marco del Consejo de Europa
Palacio de Europa (Estrasburgo, Francia), sede del Consejo de Europa desde 1977. Crédito: FrDr (CC BY-SA 4.0).
Alain Berset, secretario general del Consejo de Europa, quiere que ustedes sepan que “ya tenemos un tratado” sobre IA y que “la parte difícil” ya está hecha. Lo único que hace falta ahora es hacer cumplir ese tratado y sumar más firmantes. Pero el “tratado internacional vinculante” al que se refiere Berset dista mucho del tratado propuesto por MIRI. No me refiero solamente a que haya algunas diferencias importantes entre los dos. Imaginan amenazas por completo distintas.
Los nombres por sí solos los distinguen: MIRI pide un Acuerdo Internacional para Prevenir la Creación Prematura de una Superinteligencia Artificial. Lo que Berset defiende es un Convenio Marco sobre Inteligencia Artificial y Derechos Humanos, Democracia y Estado de Derecho.
Ahora bien, me gustan todas esas cosas que menciona el Convenio Marco (salvo quizá la inteligencia artificial, respecto de la cual entenderán que estoy un poco en conflicto). Berset no se equivoca al pensar que los modelos de IA de frontera podrían usarse para sostener regímenes autoritarios y representar una grave amenaza para los derechos humanos. Yo ya he planteado esto como una preocupación en StopWatch. Pero ahí es más o menos donde terminan las preocupaciones de Berset.
Los peligros que él imagina son fundamentalmente peligros del pasado y del presente: todo riesgo y todo problema supone una decisión que puede o debe apelarse, una autoridad a la que se le pueden exigir cuentas, un ser humano que está o podría estar en el circuito. Parafraseando al secretario general Guterres, cuyas declaraciones sobre inteligencia artificial cubrí ayer, Berset se está preparando para máquinas que siguen órdenes; no está listo para máquinas que deciden. El Tribunal Europeo de Derechos Humanos no puede ordenar una reparación por la extinción después de los hechos.
Los análisis y opiniones expresados en AI StopWatch reflejan los puntos de vista de los colaboradores individuales y de las fuentes que cubren, y no deben tomarse como posiciones oficiales del Machine Intelligence Research Institute.